咕噜纪

博主雷达 / @karminski3

karminski-牙医

karminski-牙医

AI中文博主

@karminski3

粉丝 4万关注 1,561最近同步 10/19 21:17雷达库已收录

开发者、联合创始人 · KCORES

去 X 主页

粉丝趋势近 30 天

10-12 → 10-19:+129最高 4万 · 最低 4万

近 7 天

数据积累中

情报贡献参与 1 条已上架情报 · 首发 1 条

  • 新产品Intel 在 OCP 峰会展示 Crescent Island 系列新显卡 D27010/16 00:21

最近帖子最多 20 条

karminski-牙医

给大家带来 Muse Spark Open 的测试速报, 简单来讲, Meta 这个模型可能也就在一众国产 flash 模型里面混一下了, 想要打SOTA国产模型是不可能的. 从测试效果来看, 它唯一的亮点是复杂算法实现得还可以, 但是3D效果和建模, 空间理解能力都很拉跨. 再加上它高达42B的激活参数量. 我觉得应该不会有人想本地部署使用了. 毕竟 DeepSeek-v4.1-flash prefill 只激活8B, 要什么自行车. 况且这个模型也打不过 deepseek-v4.1-flash. 所以没必要用了. Meta 想要恢复往日 llama 的荣光还需努力. 另外再多说一点, 需要注意这个模型潜在的添油加醋(幻觉)问题, 它是我测过这么多模型(70+), 唯一一个把软盘写保护滑块弄成红色的(prompt里规定是蓝色线稿). 所以这个模型可能用来写文也许会有意外收获. #MuseSparkOpen #meta #MuseSpark

karminski-牙医

坐不住了! Meta 把 Muse Spark 开源了! Meta 刚刚开源了 Muse Spark Open 大模型! 1M上下文, 支持全模态输入! 模型参数量816B-A42B, 说实话这个激活数量可不小, 尤其是对比 DeepSeek-v4.1-flash (552B MoE 主干 + 196B Engram 查找表) 这种 prefill 只激活 8B 的神奇玩意. 我还把 DeepSeek 的测试得分整合进了官方表格, 目前来看, 这个模型应该是个 Agent 能力特化模型, 不是一个编程能力很强的模型. 任何一个国产旗舰应该都能超过它的编程能力. 当然激活大除了推理更吃硬件导致速度慢以外, 还是有优点的, 一般来讲大激活对多步任务(Agent Loop)的稳定性更有帮助, 更不容易出现上下文漂移和逻辑崩溃. 不过 Meta 也补救了一手, 跟这个模型一起放出了用 PyTorch Helion DSL 编写的算子 (RoPE、RMSNorm、量化等), 在 NVIDIA GB300 上比手写的 CUDA/CuTe 算子快 1.03x~3.95x, 同一套代码直接移植到 AMD MI350 上也有类似的算子级提升 (端到端吞吐 +3%). 另外 SGLang 里还有实验性的 Helion megakernel, 把注意力、MoE 等整层操作融合成单个持久化核心 (Persistent Kernel), batch=1 的 decode 大概能快 10%. 但是这个激活量立刻让我想起了之前的 Llama 4 Scout (109B-A17B), 吹能支持10M上下文, 结果实际部署巨耗费显存, 这次更是激活参数量翻了2.47倍. 好消息是这次用了混合局部注意力, 62 层里有 46 层是 2048 token 的滑动窗口, 只有 16 层全局注意力需要存完整上下文的 KV Cache. 我试算了一下, NVFP4 权重 + 官方推荐的 FP8 KV Cache, 跑满 1M 上下文时 KV Cache 大概 34.6GB (如果 62 层全是全局注意力的话要 133GB), 加上权重 537GB 就是约 572GB, 再算上激活值和运行时开销, 官方建议至少 700GB 显存, 也就是单台 4 卡 Blackwell (比如 4×B300) 起步. 呃...总之跟我无缘了... 速报测试一会给大家放出, 看看效果咋样. 我看到 openrouter 上定价是 输入 $1.25/M tokens 输出 $4.25/M tokens, 也不便宜. > #MuseSparkOpen #Meta #MuseSpark #llama

karminski-牙医

intel 牙膏挤暴了搞了个 480G 的显卡? intel 终于开窍了, 在今年的OCP峰会上展示了Crescent Island系列新显卡的最新信息: intel D270. 我研究了一下卡的参数, 给大家分析一波这个卡运行本地模型会不会直接核弹爆炸: 首先这个卡是原生支持OCP微缩放格式标准的(毕竟intel自己参与起草的标准), 所以完全支持 OCP MXFP4(E2M1)/ MXFP8, 也就是说4bit/8bit量化根本不用软模拟, 完全就是硬件XMX加速运算. 当然 NVFP4是不行的, 这个只有N卡能用(没事可以跑MXFP4). 官方给到的它的单卡 FP8 浮点性能是 1.3 PFLOPS, 据此可以推算 FP4 能达到约 2.6 PFLOPS 这样的话如果运行 Qwen3.8-27B-8bit, Prefill 速度理论上能达到24,074tps, 4bit则可以翻倍, 达到48,148tps, 如果换成 DeepSeek-v4.1-flash-4bit, 因为 deepseek 的神奇魔法, Prefill 只需要激活 8B, 那么理论 Prefill 甚至能干到 162,500tps (实际估计应该在7万左右). 这么看来, 这张卡的浮点性能是相当够的, 即使每次都塞进去小说, 都能做到秒吐字. 重点来了, 那么这个张卡说是单卡最大 480G 显存, 这不是把老黄/水果按在地上打吗? 且慢, 我看了一下卡的零售版本其实最大是160G显存, 480G是专门给ODM厂商(HP,  DELL等)专供的. 所以单独买的话160G就是极限了(捡垃圾另算). 但好消息是, 160G 和 480G 的显存带宽一样, 都是 LPDDR5x, 能干到 1.5TB/s. 这个GPU相当猛, 给了 1280-bit位宽的显存控制器, PCB 正反两面总共贴了 20 颗 LPDDR5x 颗粒(160G 版对应单颗 8GB / 64Gb, 480G 版对应高密度的单颗 24GB / 192Gb) 所以单卡运行Qwen3.8-27B-4bit , Decode速度可以达到111tps, 而运行DeepSeek-v4.1-flash-4bit 能达到187.5tps左右 (均为理论值, 且单卡160G装不下ds, 还是要单卡480G, 或双卡160G). 而且驱动啥的完全不用担心, vLLM, SGLang, PyTorch 也都做了适配. 不过这个卡短板也很明显, 它完全没有类似 NVLink 的卡间高速互联桥, 跨卡只能走 PCIe 5.0, 单向带宽最高 64GB/s. 所以这卡就是纯粹瞄准高密度大模型推理市场的, 拿来做跨机大规模预训练是不行了, 但如果拿它单卡搞 70B 模型的 LoRA / QLoRA 微调, 超大显存会爽到飞起. 就看这卡最后给什么定价了, 要是价格合适, 真能把现在的推理加速卡市场搅得天翻地覆! (不过我看有人说定价估计要到2万刀.....)

karminski-牙医

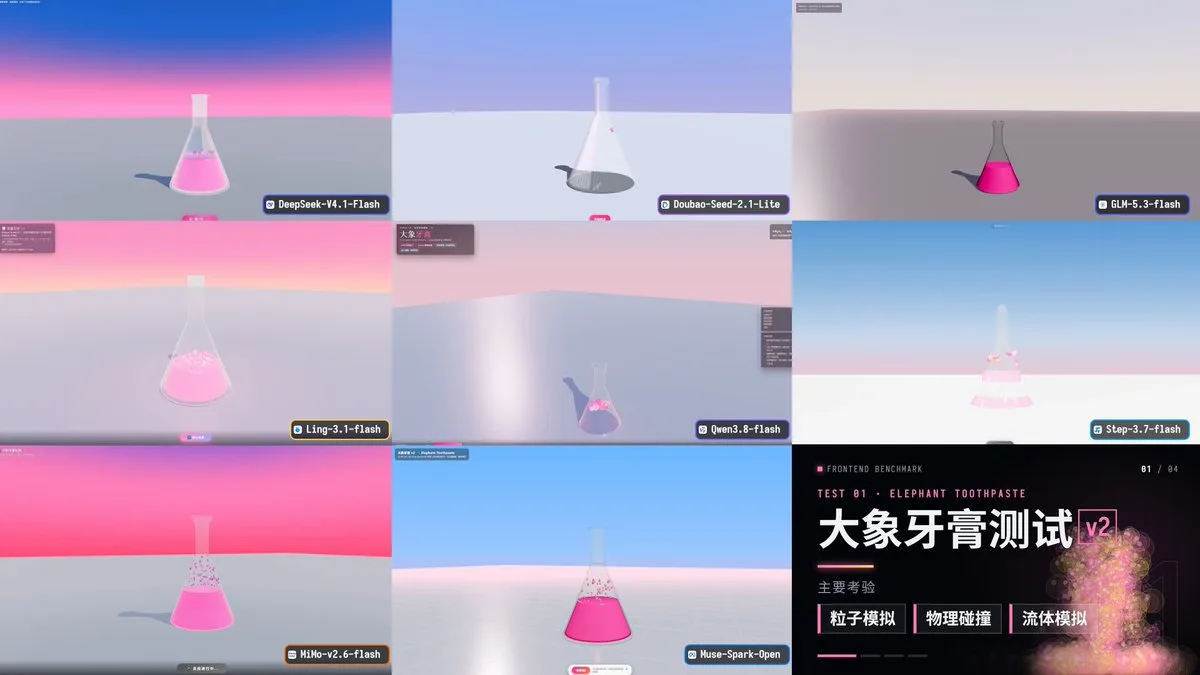
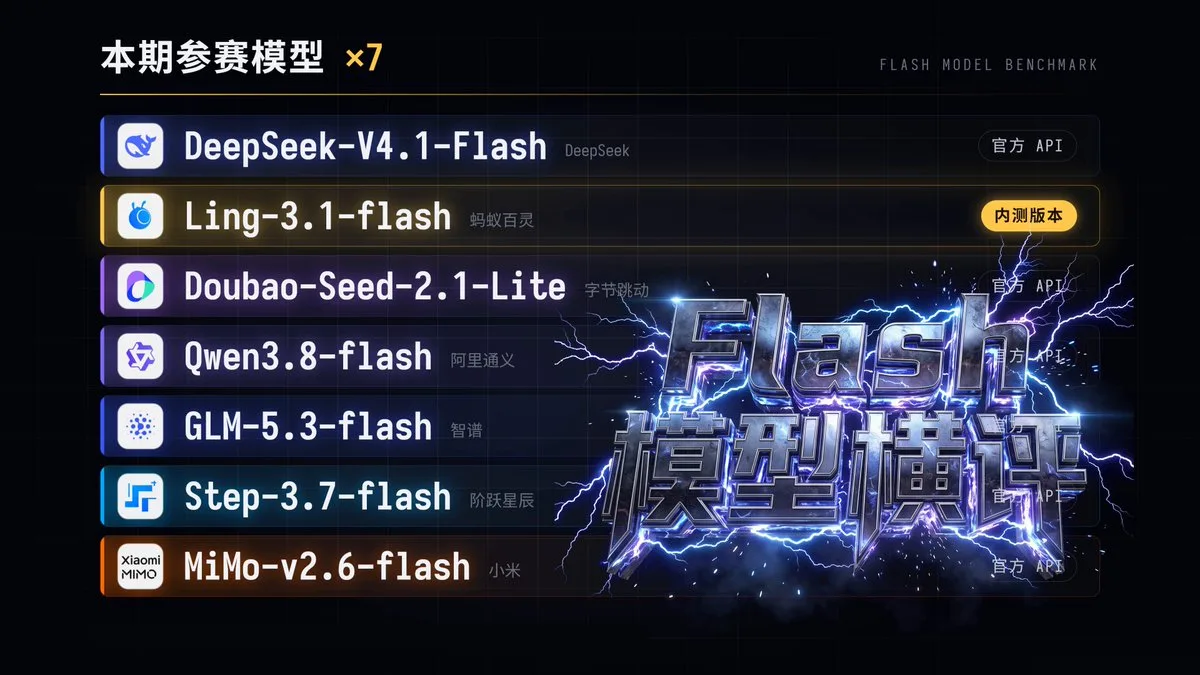
我觉得大家遇到最多的问题会是: 旗舰大模型太贵了, 日常任务是不是能用 flash 模型跑? 但是又觉得 Flash 模型可能效果不好, 甚至用 FLash 模型写代码很忐忑, 担心写出屎山. 本期给大家带来7款Flash模型横评! 让你用着放心! 快来看看你正在用的FLash模型, 能抗住压力吗? #flash模型 #ling31flash #deepseekflash #mimov26flash #蚂蚁百灵