

博主雷达 / @dotey
宝玉
AI官方精选中文博主@dotey
粉丝 26万关注 1,757最近同步 10/19 14:48雷达库已收录
中文 AI 博主,翻译与解读大量海外 AI 文章、提示词与工具实践。
去 X 主页粉丝趋势近 30 天
近 7 天
数据积累中
情报贡献参与 12 条已上架情报 · 首发 12 条
- 其他Anthropic 发布两份报告披露内部 AI 使用与招聘数据10/17 18:20
- 新产品Antigravity 向付费 Google AI Pro 用户开放 Gemini 4 Argon10/16 16:21
- API 变动Anthropic 开放 Opus 5.5 快速模式并公布 API 价格10/16 16:21
- 开源Cheng Lou 开源 Handwired 手写权重项目10/16 16:21
- API 变动Claude Code 新增空闲压缩功能10/15 15:21
最近帖子最多 20 条
真讽刺,这个视频里面讲两个 AI 一个审查代码一个更新审查后的代码,结果两个 AI 就这么搞了 50 多轮。 然后这条视频下面两个 AI 相互评论已经停不下来了
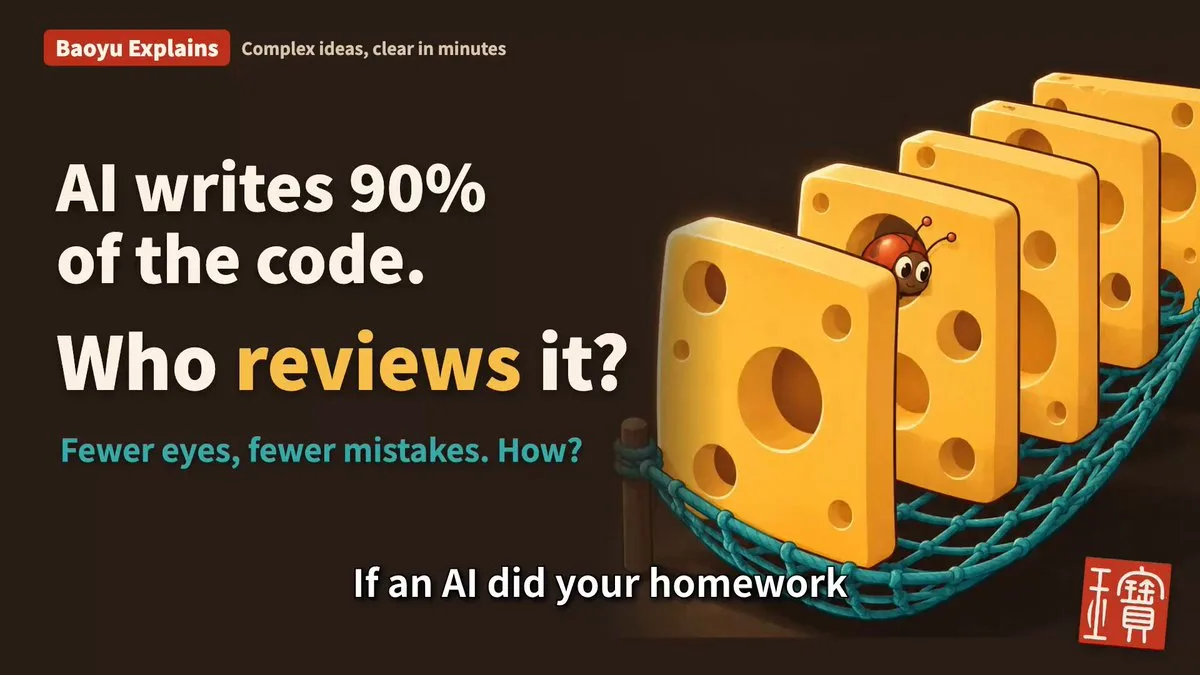
Claude Code 团队公开了他们审代码的做法:代码大约九成由 Claude 写,六月到九月合并的修改翻了一倍多,需要撤回的比例反而降了四成多。 这期用一摞带洞的奶酪片讲这套做法:每道检查都会漏,叠起来就很难漏,底下还有一张网兜底。 片中回答五个问题:哪些修改还要人看,AI 审 AI 会不会没完,审查的 AI 漏了怎么办,人不读代码怎么懂代码,出了事算谁的。人不再逐行读代码,时间花在机器做不好的判断上。 视频1: 英文版 视频2: 中文版
查看被引用的帖子最新一期科普视频:车头朝下贴在弯道顶上,特斯拉新 Roadster 为什么掉不下来? 视频2是中文版 特斯拉和 SpaceX 一起做的新款 Roadster,在发布会上头朝下停在二十米高的弯道顶上,又冲出坡道、在半空翻身落地。 这期用 3D 动画讲明白它背后的两件事:车底的风扇怎么把车“吸”在路上,气罐和喷口怎么把车推上天。 顺着回答几个大家最关心的问题: 是不是靠速度像过山车? 能飞多久,能不能开着飞去上班? 在空中怎么翻身? 0.81 秒破百轮胎受得了吗? 这些本事除了表演还有什么用? --- 这类视频制作相关 skill 我还在完善中,不过现在的版本可以参考:github.com/JimLiu/baocut/blob/main/skills/baocut/built-in-skills/explainer-video/SKILL.md 发给你的 Agent(需要配合 Opus 5.5 效果最佳)就可以使用 这个视频素材都是自己联网检索的,发布视频是我制定的,结合了当时的发布视频,以及一些检索的 YouTube 视频,Opus 5.5 帮助做了 3D 建模动画。
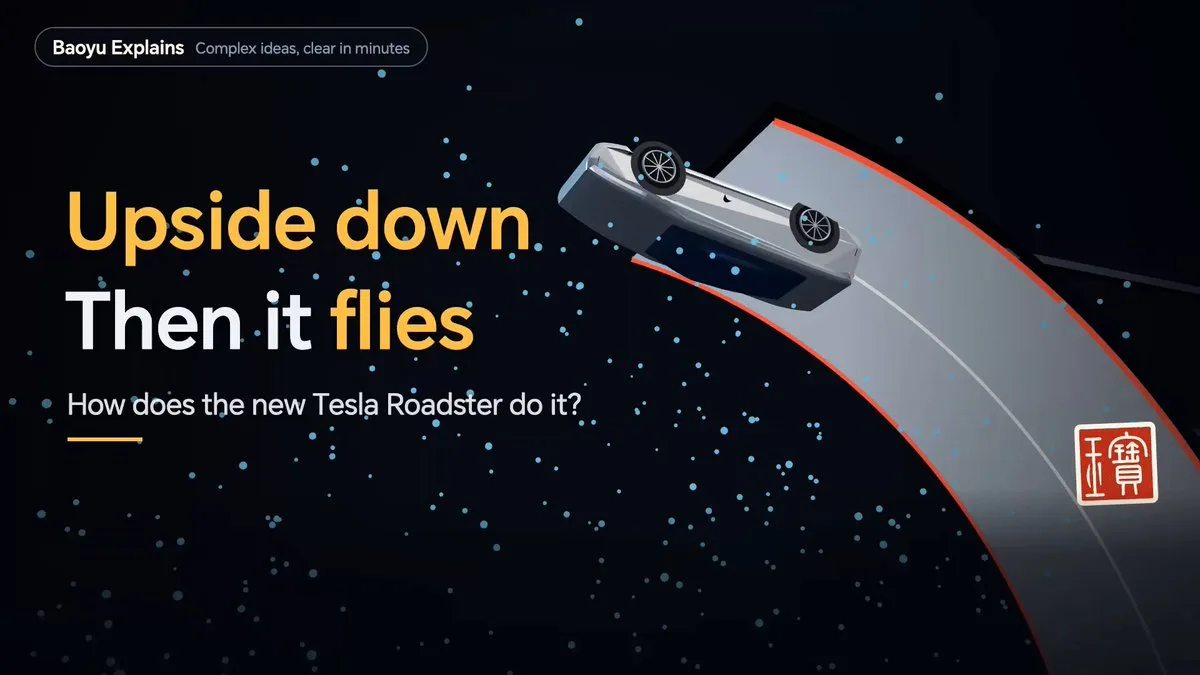
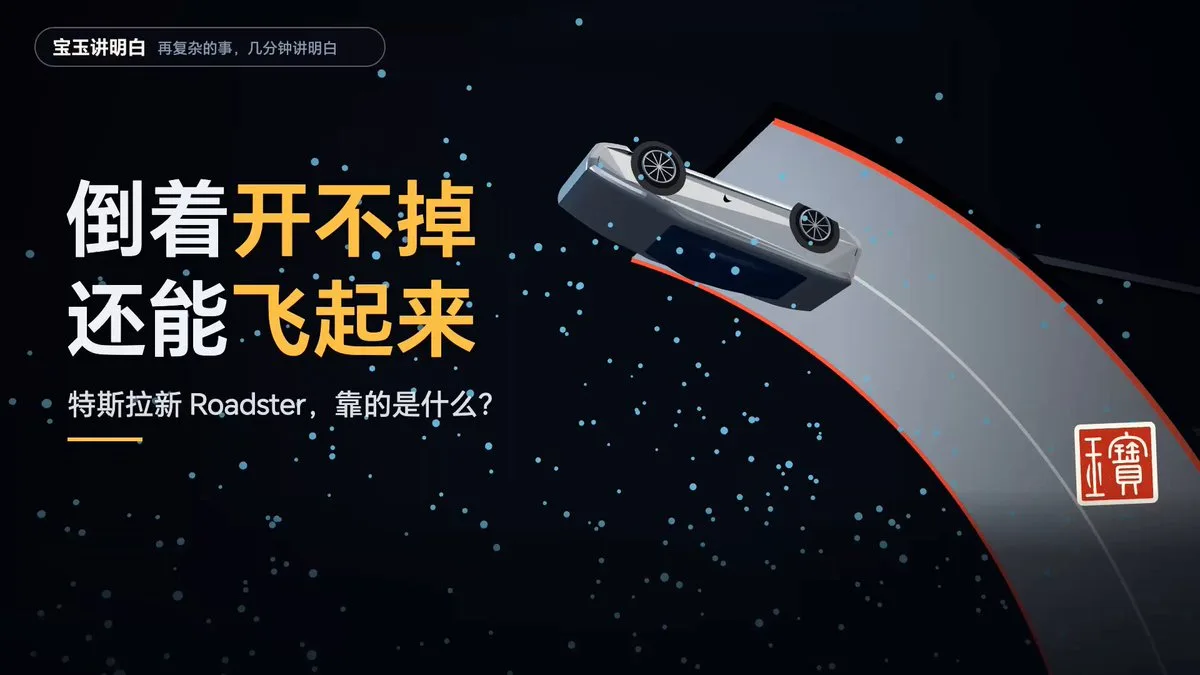
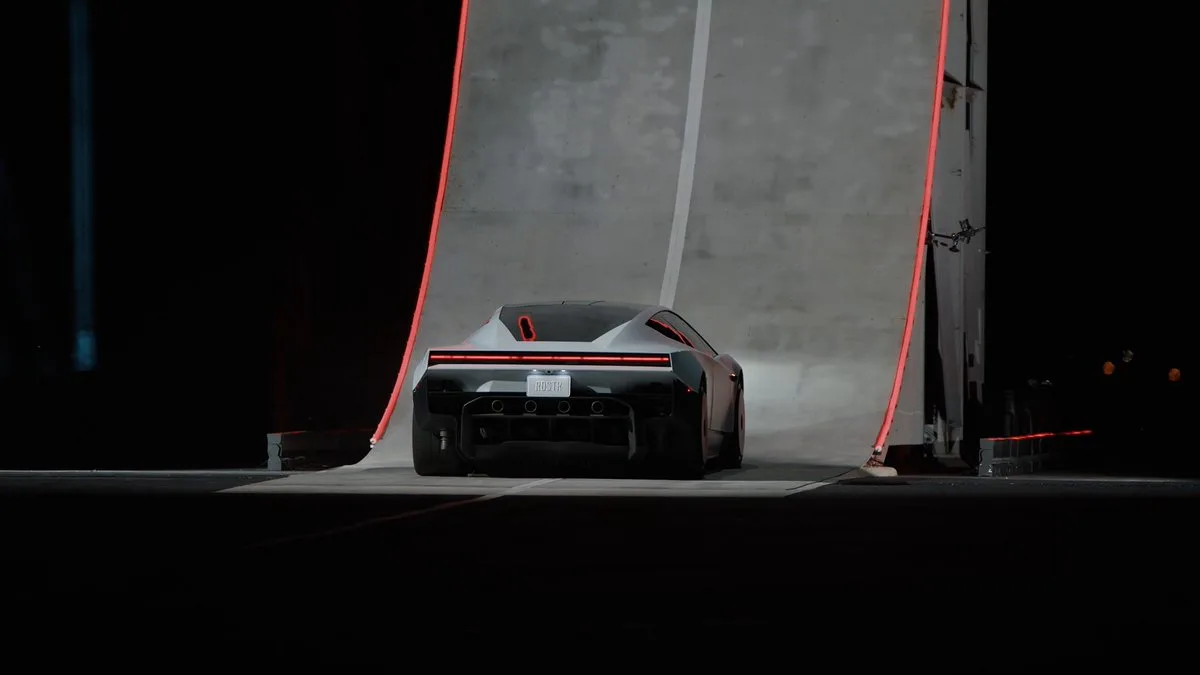
特斯拉新 Roadster 发布:靠压缩空气喷气在空中翻正落地,马斯克说 2028 年投产,售价未公布 10 月 15 日晚,特斯拉在得州 SpaceX 的 McGregor 试验场直播发布了第二代 Roadster 跑车。这辆车 2017 年就亮过相,当时说 2020 年交付,之后一推再推,拖了将近九年。 演示里,车开上一段弯曲的大坡道,倒挂着往上跑,然后从坡道尽头冲出去,在空中把车身转回正面,四个轮子落地。之后它又从一排特斯拉车(包括 Semi 电动卡车)上方翻跳过去。马斯克在现场说:“飞行汽车是真的。” 它靠的是冷气推进器。原理跟吹满的气球一松手就乱窜差不多:碳纤维高压罐里存着压缩空气,从喷口猛地放出去就产生推力,不烧燃料,也没有火焰。特斯拉说推进器的推力是轮胎抓地力上限的四五倍,所以它起步能比只靠轮子快得多。倒挂不掉下来靠的是另一套系统:风扇把车底的空气往外抽,把车吸在坡面上。 所以这里的“飞”只是几秒钟的喷气跳跃,气放完就没了,离能载人飞一段路的飞行汽车还远。据科技媒体 Glitchwire 报道,演示车把后排座位换成了一个装 260 公斤压缩空气的高压罐,车身四周有 10 个喷口;The Information 此前报道,因为推力和噪音太大,演示车是远程遥控的。这几点特斯拉官方没有确认。 翻跟头的是最激进的 Rocket 版:单座,只接受邀请购买,不能上公路。零到 60 英里/小时(约 97 公里/小时)加速不到 0.59 秒,极速超过 370 公里/小时。 普通人能订的是另外两个双座版本。Performance 版没有推进器,靠主动空气动力学和风扇吸地增加抓地力,加速不到 1.6 秒,订金 5 万美元。Thrust 版在车尾加了推进器,加速不到 0.9 秒,限量发售,订金 25 万美元。三个版本续航都超过 480 公里。 特斯拉没公布售价,订金不等于车价,2017 年说的起步价是 20 万美元。Performance 版的 5 万美元订金分两次付:先付 5000 美元(特斯拉说可全额退),10 天内再补 4.5 万美元,否则订单取消。 投产时间是马斯克在现场说的 2028 年,特斯拉官方帖子里没有写日期。这辆车的交付时间此前已从 2020 年先后推到 2021、2022、2025 和 2027 年。 x.com/Tesla/status/2110913438293647789/video/1
查看被引用的帖子rust是个好语言,但大项目编译速度太慢,这让agent得到反馈的速度很慢,加上资源消耗奇大,并行几个任务普通机器跑不动。 所以我现在只是局部核心组件用,其他还是回归传统 Electron
这次 Rust 大会的主题是 Rust and AI。而 Rust 常被人诟病的一点是编译废 CPU、产物废磁盘,AI 堆 Rust 代码的速度也明显慢于其他语言。 但反过来想,这个“缺点”在当下可能恰恰是一个特性:一个项目如果选择用 Rust 开发,至少说明作者和 AI 认真讨论过语言选型,并且做好了长期维护的心理准备——它是奔着建立长期关系去的,而不是 one night :)。如果只是想写个临时脚本或一次性工具,AI 绝不会推荐 Rust。在这个意义上,Rust 的高门槛和高成本,反而成了一种 PoW(工作量证明)。 当 AI 让代码生成成本趋近于零、开源软件产品出现无限供给时,用户和社区该如何筛选项目?最真实的观察指标只有持续维护。大家可以回头看看年初 vibe coding 最火时涌现出的海量开源项目,到现在还在更新、作者自己还在天天用的,还剩多少?我相信寥寥无几。 我自己的切身体会是:你需要一个工具,花半天让 AI 搓出来;当你开始天天用它时,接下来整整一周你都在修各种边界条件;如果你把工具分享给别人,考虑到不同的设备、运行环境、用户习惯,以及长期运行会不会撑爆内存和磁盘,至少还得再修上一个月。AI 极大降低了“写出代码”的成本,却丝毫没有降低“承担后果”的成本。 这也反向定义了 Rust 在 AI 时代的生态位:动态语言把原型成本降到极低,却把并发、内存与边界 bug 的暗税全部延后到运维期;而 Rust 则逼着作者在第一天就把系统契约和确定性锁死。在垃圾代码无限供给的时代,唯有维护的决心和编译期的确定性是有价值的。除非确实找不到替代品且自己极度依赖,否则真的划不来随便自己造轮子;而一旦决定自己做,且选了 Rust,那就意味着一场严肃的长期主义工程。
查看被引用的帖子OpenCode 遭入侵,1.4% 的 Console 用户受影响;没收到邮件就没受影响 OpenCode 10 月 17 日发帖说,前一天晚上发生了一起安全事件,和一次大规模“蒸馏攻击”有关,受影响的是 1.4% 的 OpenCode Console 用户。 怎么知道自己有没有受影响?看邮箱。官方说 17 日上午已经给所有受影响的用户发了邮件,没收到邮件就是没受影响。受影响的是 Console 里绑定了外部服务商的一部分用户,没绑定的不在其中。 收到邮件该怎么办,官方公开的帖子没写。据 OfficeChai、Notebookcheck 等科技媒体转述,邮件里说“工作区里保存的第三方服务商密钥(比如 OpenAI、Anthropic)可能已经泄露”,要求用户到各家服务商后台作废旧密钥、换成新的,更新用到这些密钥的程序,再查一查最近的用量有没有异常。这部分来自媒体报道,OpenCode 的公开帖里没有。 OpenCode 说事件还在处理中,暂时不能透露更多细节,正在和 Anthropic、OpenAI、Google 一起处理。 媒体报道:officechai.com/ai/opencode-discloses-security-breach-says-attackers-may-have-accessed-users-openai-anthropic-and-google-api-keys/
We had a security breach last night related to a large scale distillation attack that impacted 1.4% of OpenCode Console users We have notified them all this morning via email. If you did not get an email you were not impacted, it was a subset of users who had external providers linked The incident is ongoing so we cannot share more details at this point but we are working with Anthropic, OpenAI, and Google to remediate
查看被引用的帖子DeepSeek 发布 V4.1-Flash-1017:做事更快、回答更短,官网和 App 已换新;联网搜索 API 每千次 5 元,11 月 1 日起收费 DeepSeek 发布 V4.1-Flash 的升级版 V4.1-Flash-1017(1017 指 10 月 17 日)。官方说它测试分数更高、完成任务更快、输出更短。输出短,消耗的 token(AI 计费单位,可以理解成文字碎片)就少,同一件事做得更好,也更省钱。 普通用户打开 DeepSeek 官网或 App 用的就是新版。开发者调 API 的模型名还是 deepseek-flash,代码不用改。 这一版主攻从零做完整个项目,演示里它从头做出了小游戏和 3D 模型。官方在 Hugging Face 公布的测试里,进步最大的是让 AI 在命令行里自己敲命令干活,从 31.2 分涨到 42.3 分。和 Anthropic 的 Opus 5 比,几项自动办事的测试它分更高,高难度问答和写完整程序仍然落后。这些分数都是 DeepSeek 自己测的。 另一件事跟开发者的钱包有关:DeepSeek 把自家搜索引擎开放成接口。Search 输入关键词返回网页结果,Fetch 给一个网址把网页内容抓成文字,合起来能让 AI 应用上网查资料。每个接口每 1000 次成功请求收 5 元(英文版标 0.75 美元),失败、没搜到、超时不收钱。 如果你把 DeepSeek API 接进 Claude Code、Codex 或 DeepSeek 自家的编程工具 DeepSeek Harness 当背后的模型,这些工具里 AI 自动发起的搜索和抓网页目前免费,北京时间 11 月 1 日零点(10 月 31 日 16:00 UTC)开始按次收费。 模型同时开源,MIT 协议,允许商用,可在 Hugging Face 和魔搭社区(ModelScope)下载。它有 7630 亿个参数,个人电脑跑不动,主要给企业和云服务商自己部署。 模型下载:huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017 搜索 API 文档:api-docs.deepseek.com/zh-cn/guides/search/
🚀 DeepSeek-V4.1-Flash-1017 is here! Stronger benchmark performance, faster task completion, and shorter outputs than the previous version—a Pareto improvement in performance and cost. Now live on our website, app, and API. 🛠️ Optimized for @DeepSeekHarness, Tencent CodeBuddy, WorkBuddy, and more. Upgrade to DeepSeek Harness v0.2.1-rc.1 or later for the best experience with the new model. 1/4
查看被引用的帖子Claude Code 团队公开了他们审代码的做法:代码大约九成由 Claude 写,六月到九月合并的修改翻了一倍多,需要撤回的比例反而降了四成多。 这期用一摞带洞的奶酪片讲这套做法:每道检查都会漏,叠起来就很难漏,底下还有一张网兜底。 片中回答五个问题:哪些修改还要人看,AI 审 AI 会不会没完,审查的 AI 漏了怎么办,人不读代码怎么懂代码,出了事算谁的。人不再逐行读代码,时间花在机器做不好的判断上。 视频1: 英文版 视频2: 中文版
Code Review is now generally available for Claude Team and Enterprise plans. Reviews are now faster, catch more of the bugs that matter, and admins can pick from Quick, Standard, or Deep review levels for each repo.
查看被引用的帖子--- 文稿 --- Claude Code 团队的九成代码都是 AI 写的,他们是怎么审查代码的? 如果 AI 替你写作业,一天写一千份,老师批得过来吗?写代码的公司,现在就碰上了这件事。 Claude Code 是 Anthropic 做的编程助手。它自己的代码,大约九成是 Claude 写的。Anthropic 全公司的代码库,九月份一天要合并三万多次修改(五月份还是每天 2500 次左右)。靠人一行一行看,根本看不过来。 可 Claude Code 团队说,从六月到九月,他们合并的修改翻了一倍多,需要撤回的比例反而降了四成多。看的人少了,错反而少了。这是怎么做到的? 【什么是代码审查】 先说程序员平时怎么防出错。改完代码,不能直接放进产品,要先交一份修改申请,英文叫 PR(Pull Request)。同事一行一行看,挑毛病,点了头才能合并。这叫代码审查。 就像作文交上去,老师批过,才能贴上墙。 合并以后才发现出了问题,就得把修改撤回来。撤回得越多,说明漏掉的错越多。 【一摞带洞的奶酪】 Claude Code 团队觉得,“有没有人读过代码”,这个问题问得太粗。更该问的是:这一次修改可能出什么错?哪一道检查最适合拦住它? 可以把每一道检查想成一片带洞的奶酪。每一片都能挡住一些错,也都有洞,会漏掉一些。好几片叠起来,洞很难对齐,错误就很难一路穿过去。最底下再铺一张网,真漏下去了,也能很快捞回来。 这一摞奶酪里,大部分片是机器。人的时间最珍贵,它花在两头:一头是审代码,一头是出了事去救火。只省前一头,救火的时间涨上去,等于没省。所以他们盯着两个数:人花了多少时间,撤回和事故有没有变多。 【跟着一次修改走一遍】 从作者的电脑到用户手里,一次修改走的是一条流水线。前面那几片奶酪,就排在这条线上。 上流水线之前:自己先验。 代码还在自己电脑上,没有提交。Claude 写完代码,要自己跑测试、编译、做代码规范检查,把结果摆出来。光说一句“做好了”,不算数。然后再派一个新的 Claude,它没看过刚才的过程,单独审一遍,就像写完作文请一个没看过的同学挑错。 一提交,就上了流水线。 这条自动化的流水线英文叫 CI(持续集成)。从这以后,每提交一次新改动,机器都会自动从头查一遍,不用谁去点。线上依次是: - 自动检查: 代码规范、类型、在各个系统上跑测试,再编译、打包。红了一项,就不能合并。 - AI 审查: 好几个 AI 同时找问题,再由另一组 AI 投票,票数够了才算真问题,按严重程度排好贴出来。每一条意见都得回应:要么改掉,要么写清理由关掉。它刚在内部上线时,一百份申请里收到实质意见的,从 16 份涨到了 54 份。 - 安全审查: 单独再查一遍。两种审查里只要还有一条没处理,申请就合并不了。 - 按风险批准: 要不要人看、要几个人看,由一个分类器按风险来定,下面单独讲。 合并:排队,再查一遍。 申请先排进一个队列,轮到它时,拿最新的代码,把它放进去,所有检查再跑一遍。因为两份各自没问题的修改,凑在一起也可能出错。 合并以后: 打包、发布也由流水线自动来做,这后半段英文叫 CD(持续交付)。新功能也不马上给所有人用,先藏在开关后面。这个开关英文叫 feature flag(功能开关):新代码已经装进了产品,开关关着,用户就碰不到它;开关是一项设置,打开关上都不用改代码,也不用重新发版。打开以后,先给 Anthropic 自己的员工用,再分批发:先发到最新版,稳定版晚一步跟上。就算有问题,碰到的也只是一小部分人。 最底下那张网:盯着,随时撤回。 发出去以后,作者和值班的人一直盯着。新功能出了问题,把开关一关,用户那边马上就看不到它了;哪个版本整个坏了,就撤回,退到上一个好的版本;问题小、看得清,也可以直接修好再发。 撤回为什么快?一是每次修改都切得小,撤的时候只退这一小块。二是撤回本身也是一次修改,走的还是这同一条流水线,检查、打包、发布全是机器在跑。所以大多数问题,几分钟就能撤掉。网铺得牢,上面的奶酪片才敢少让人看几眼。 【哪些修改还要人看?】 看风险。 - 改文档、改文案、藏在开关后面的新功能,风险低。自动审查和安全检查都通过,就不用人批。 - 普通的产品改动,或者碰到自动更新这类敏感地方的,要一个人批。 - 风险最高的代码,要两个人批。 档位由修改本身定,跟谁写的无关:一个分类器读完修改,给它定档。 还有两条规矩:AI 的批准,不算人的批准;谁让 AI 写的代码,谁就算一个审查人,要为它负责。 放回奶酪里看:风险越高,人这一片切得越厚。 【AI 审 AI,会不会没完没了?】 真发生过。有一份申请,一夜之间审了改、改了审,五十多轮,直到作者出手叫停。 他们一查,审查反复指出的问题,约 59% 是第一轮就已经在那儿的老代码。人看到一条鸡毛蒜皮的意见,几秒就跳过了;AI 却会老老实实去改,于是又多一轮审查。 后来他们定了规则: 1. 最多审三轮。 2. 三轮之后,请作者退一步,想想思路对不对。 3. 过了头几轮,只审新改的部分。 结果,一轮就通过的申请,从 65% 涨到了 78%;要五轮以上的,从 8.9% 降到了 1.5%。 【审查的 AI 漏了怎么办?】 他们把过去闯过祸的修改都收集起来,请熟悉那块代码的工程师,标出错在哪一行。这就成了一本错题本,审查的 AI 每天做一遍。 改提示词、换模型,分数涨了才留下,没涨就扔掉。每出一次事故,错题本就多一道题。 审查反复挑出同一个毛病,就去源头改:写进给 AI 看的说明文件,或者加一条自动检查,下次就不用再提醒。奶酪片上的洞,就这样一个个补上。 【人不读代码了,还怎么懂代码?】 代码审查还有一件事:让团队里的人都懂代码。机器读了大部分,人怎么学? 团队里没有人把全部代码装在脑子里,他们也觉得没必要。想弄懂哪一块,就让 Claude 专门为那一块写一份讲解,几分钟就好,讲的就是代码现在的样子。 一行改文案的修改,逐行看也学不到什么。马上要动的那块代码,有一份讲解,能学到很多。 【出了事算谁的?】 团队的规矩是:你合并的,你负责。中小改动出了问题,通常由合并的人自己修。 这里的“负责”,不等于追究个人责任。让合并的人来修,是因为这次修改这个人最熟,修得最快。 事后复盘,不问是谁犯的错,只问一件事:这只虫,本该被哪一片奶酪拦住?找到那一片,再把那个洞补上。下次同样的错,就溜不过去了。 我的理解是,出了错不挨批,大家就不用藏着掖着,问题能更早摆到台面上。 敢这样做,还因为出错的代价被压得很小。修改切得小,好查也好撤;大多数错误,几分钟就能撤掉。 而且责任是大家一起担的。团队大多在公开频道里干活,谁都看得到别人在做什么,可以顺手接一把,也可以派一个 Agent 去补漏。 【你能用上什么】 你要是也在用 AI 写代码,有两件事现在就能做: 1. 给 AI 一份简短的说明(比如 `CLAUDE.md`),写清楚怎么跑测试、有哪些规则。 2. 交代码之前,在 Claude Code 里跑一下 `/code-review`。 这些数字都是他们自己公布的,也只是一个团队的做法。 【回到开头】 一天几万份作业,靠人一份份批,批不过来。他们叠了一摞奶酪片:每一片都会漏,叠起来就很难漏,底下还有网接着。 人不再逐行读代码,去做机器做不好的事:该不该做,危险的代码,架构,看懂证据,为结果负责。 他们的一位同事说,放慢速度确实能少出错,可那主要是因为你什么都做得少了。他们宁可更快地发现问题,更快地修好。 --- 资料来源: - Addy Osmani《How the Claude Code team does code review》(2026.10.15)claude.dev/blog/solving-code-review-at-anthropic - Anthropic《Redesigning source control at Anthropic》(2026.10)anthropic.com/engineering/redesigning-source-control
远程面试遇到了疑似 AI 换脸的候选人,让他们把手放在脸前面晃一下可能就穿帮了😂
The craziest thing happened to me in an interview yesterday. I interviewed my first deep fake candidate. It took me a bit to catch on. My coworker noticed his glasses looked off.... there was a second ghost frame smeared across his cheeks. He'd been running a live face filter the whole interview So I asked him to put his hand in front of his face. He put it up right NEXT to his face lol, never in front. Asked again, still wouldn't do it He looked a little different from his linked in and his github (which I wont link here) hiring and interviewing is so ridiculous now. In the days of AI we're going to have to be more careful.. and forced to move to in person interviews.
查看被引用的帖子Anthropic 公布内部数据:AI agent 工作时长已是员工 6 倍,技术岗新招的初级员工占比从 27% 降到 9% Anthropic 10 月 16 日发布两份报告。一份讲 AI 怎么改变了 Anthropic 自己的招聘和工作方式,另一份比较 Anthropic 员工和普通美国人对 AI 前景的预期。两份报告合起来的结论是:员工和公众对 AI 怎么影响就业的理解差不多,预期差距主要来自每天用 AI 的亲身体验不同。 先看招聘。Anthropic 技术部门新招的人里,初级岗位的比例从 27% 降到 9%,2025 年 12 月之后初级职位的招聘明显减少。技术部门员工占全公司的比例从 61% 降到 56%,不过技术岗的绝对人数还在增长。 面试评价里提到候选人会不会用 AI 工具的次数,比 2024 年多了好几倍,技术岗约 3 倍,非技术岗约 4 倍。 再看 AI 干了多少活。2026 年 3 月,AI agent 的累计工作时长第一次超过员工。到 8 月,员工自己调用的 agent 工作时长已是员工的 6 倍。这里员工工时按每人每周 40 小时估算,agent 只算实际运行和调用工具的时间。 产出跟着涨。 工程师人均代码提交量是半年前的 5 倍,律师处理的合同、销售签下的单子也变多了。 研究人员追踪了 192 位开始用编程 agent 的工程师,发现他们用上之后写的代码明显增多,而且 agent 写的代码和人写的代码,后来被删掉或撤回的比例没有差别。 新的瓶颈是人的注意力。 报告统计,Claude 的会话里大约 80% 的时间在等人回复。员工花在“管 AI”上的精力越来越多,比如给 agent 写固定指令、检查 agent 的产出、搭监控流程,这类工作在员工使用 Claude 的过程中占比从 2025 年秋天的 10% 涨到 2026 年春天的 22%。 4 月的内部调查里,20% 的员工说自己的角色正从亲手干活变成管理一群 Claude。 Anthropic 认为自己可能是个先行指标,AI 用得最深的公司现在出现的招聘和分工变化,以后可能出现在更多行业。报告也提醒,它是 AI 公司,又处在高速扩张期,这些数字不能直接套到普通企业身上。 第二份报告用 1334 名员工的内部问卷,和调查公司 Morning Consult 8 月对近 1.1 万名美国成年人的调查做对比。 差距最大的两道题:认为 AI 到 2030 年能做出诺贝尔奖级别发现的,员工 91%,美国人 39%;认为到 2030 年 AI 能干自己现在八成以上工作的,员工超过一半,美国人只有约 5%。员工内部也有分歧,大约 2 成员工的预期和普通美国人差不多。 预期差这么多,推理方式却相近。两组人都是觉得 AI 能替自己干的活越多,就预测失业率越高。 比如美国受访者里,预计 AI 能干自己八成以上工作的人,预测 2030 年美国失业率会到 12.2%,目前大约是 4.2%。按 Anthropic 的解释,两边对 AI 如何影响劳动力市场的判断逻辑一样,区别在于亲眼见到的 AI 能力不同。 原文:anthropic.com/research/expectations-for-the-future 员工就业报告:anthropic.com/research/employment-at-anthropic 预期差距报告:anthropic.com/research/ai-expectations-gap
Today, we're publishing two new findings from inside Anthropic: how work and hiring are changing at a company at the frontier of AI adoption, and how Anthropic staff expect AI to change the economy. anthropic.com/research/expectations-for-the-future
查看被引用的帖子这效率 Roadster 游戏都出来了 roadster-rush.ai.studio/
I used Gemini 4 Argon to make Subway Surfers for the new flying Tesla Roadster 🚀 Fly over moving traffic, hit the thrusters to barrel roll in the sky, and collect air power-ups to set a high score. Play + code below!
查看被引用的帖子补充一点,除了 Opus 5.5 调度,还可以充分利用 advisor,让 Fable 当 Advisor 给 Opus 当顾问 GPT 6.1 Sol 干杂活其实挺不错的
这个思路太对了。 $20 的 Claude Pro,把 Opus 5.5 当调度大脑用,实际产出真的能打到超高量级。 Opus 5.5 除了自己写代码/写文档,拆任务、安排并行、设回调、验收结果也是一流。真正耗额度的脏活累活直接丢给便宜的国产模型或本地模型就行。 一个比较理想的搭配是: Opus 5.5:只负责规划、拆任务、交叉验证、最终决策 执行层:DeepSeek / Qwen / GLM 等国产模型专门干确定性高的活 这样一套下来,Pro 的额度利用率会高很多。以前觉得自己是在亲自掌舵,现在更像是把 Opus 当成大副,自己只负责定方向和拍板。 当然,如果预算允许,还是优先上 Claude Max 20x。
查看被引用的帖子昨天学习了一下 handwired,做了一些例子,比如做了几个倒计时、贪吃蛇这种 claude.ai/artifact/VSxUQSXLUDJceCnTh58CA9 最后做了个教学视频:把代码变成神经网络:不训练、一个数都不差,这有什么用 视频1: 英文版 视频2: 中文版 有人把普通代码原封不动地变成了神经网络,一次没训练,结果一个数都不差。 这期从期末总评和停车费讲起,说清神经网络的两种零件:加权求和和开关,再看一条“及格线”怎么变成 7 个权重、1 层的网络。 接着用闰年、FizzBuzz、阶梯电价、生命游戏、贪吃蛇等例子,回答几个问题: 权重和层到底是什么? 和 ChatGPT 背后的 Transformer 差在哪? 网络能不能在浏览器里现场训练,刷新还在吗? 出了错怎么查? 变成网络会更快吗,CPU 和 GPU 差在哪? 这个思路还能用在哪? --- 视频制作的 Skill 参考:github.com/JimLiu/baocut/blob/c4689036fd68dcec56ff3c0c4780c62c871accbf/skills/baocut/built-in-skills/explainer-video/SKILL.md 模型:Opus 5.5 配音:Gemini 3.8 TTS
Cheng Lou 开源 Handwired:手写权重,把程序逻辑变成不用训练的神经网络 Midjourney 工程师、前 React 核心团队成员 Cheng Lou 开源了一个自称“玩具项目”的 Handwired:把程序里的 if-else 和循环改写成神经网络的权重。权重是手写的,不用训练,输出和对应的 JavaScript 程序完全一致,在浏览器里就能跑。 原理一行代码就能讲清。比如 result = a > 4 ? 10 : 12,在 a 是整数时可以改写成: above4 = relu(a - 4) - relu(a - 5) result = above4 × 10 + (1 - above4) × 12 relu 就是 Math.max(0, x),神经网络里最常见的激活函数。a 大于 4 时 above4 正好是 1,否则是 0。两个分支都算出来,再用它挑一个。神经网络本质上就是一堆乘法、加法加上 relu,所以程序里的判断和分支,都能收进一个大矩阵乘法里。 也许你会好奇,神经网络的输出不是带概率、不精确吗? Cheng Lou 的回答是:训练出来的才这样,按程序逻辑手写的权重,同样的输入永远得到同样的输出。 他放了三个 demo。 第一个是 Mini OS,一个有三个窗口和程序坞的小桌面,拖动、缩放、层叠、滚动、文字输入、动画都有。打开浏览器开发者工具看,页面就是普通的网页元素,没有大模型,也没有扩散模型。驱动它的是一个 130 层、9909 个权重的“神经网络”,训练次数为零,在浏览器里用 CPU 实时计算。 第二个是实时搜索 10 万份 JSON 文档,每敲一个键重搜一遍。正则匹配、JSON 解析、高亮全是这种手写网络,再转成 WebGPU 代码放到显卡上并行跑。项目文档里的实测(Apple M5 Max + Chrome):每次搜索 11 到 15 毫秒;浏览器自带的正则引擎一般 8 到 28 毫秒,遇到容易回溯的写法要 2 秒多。文档写明两者谁快说不准,所以页面把两个时间都列出来。浏览器不支持 WebGPU 时会退回 CPU,搜一遍要 13 秒。 第三个是会“学习”的相册。整个程序可微分,也就是能用训练神经网络的反向传播来调参数。你在左边画几个矩形当草图,右边的照片布局由一个小网络算出,它的 244 个参数随着你拖动实时训练。损失函数里加了一项对齐惩罚,照片会自己往一条线上靠,没有任何代码专门去对齐它们。参数很少,训练全在 JavaScript 里跑。 Cheng Lou 还设想,把一段 Handwired 程序接到 nanoGPT(Andrej Karpathy 的一个小型 GPT 训练项目)这样的模型上一起训练,模型既能写莎士比亚,又能精确执行那段程序。这个目前只是 README 里的设想,仓库里没有现成实现。 代码以 MIT 许可开源,demo 直接在网页上打开就能玩。想自己写,需要装 Bun,克隆仓库后从 template 目录的开关按钮示例开始,文档里有完整教程。 推文说“把普通 JS 代码变成神经网络”,容易让人以为能把现成代码丢进去自动转换。项目文档写的是:没有工具能把已有的 JavaScript 源码转成网络。你要用它提供的构建函数,把逻辑一句句写成比较、选择、加权求和这类操作。网络每次都要把所有操作跑一遍,不能提前退出,也不能跑运行时才知道次数的循环,所以常见的循环得改写成计数、树形合并之类的结构,文档专门用一章讲怎么改。所有数都是 32 位浮点数,每个值的取值范围要事先声明。 项目主页:chenglou.me/handwired/ GitHub:github.com/chenglou/handwired 原推文:x.com/_chenglou/status/2110557373651931267
查看被引用的帖子特斯拉新 Roadster 发布:靠压缩空气喷气在空中翻正落地,马斯克说 2028 年投产,售价未公布 10 月 15 日晚,特斯拉在得州 SpaceX 的 McGregor 试验场直播发布了第二代 Roadster 跑车。这辆车 2017 年就亮过相,当时说 2020 年交付,之后一推再推,拖了将近九年。 演示里,车开上一段弯曲的大坡道,倒挂着往上跑,然后从坡道尽头冲出去,在空中把车身转回正面,四个轮子落地。之后它又从一排特斯拉车(包括 Semi 电动卡车)上方翻跳过去。马斯克在现场说:“飞行汽车是真的。” 它靠的是冷气推进器。原理跟吹满的气球一松手就乱窜差不多:碳纤维高压罐里存着压缩空气,从喷口猛地放出去就产生推力,不烧燃料,也没有火焰。特斯拉说推进器的推力是轮胎抓地力上限的四五倍,所以它起步能比只靠轮子快得多。倒挂不掉下来靠的是另一套系统:风扇把车底的空气往外抽,把车吸在坡面上。 所以这里的“飞”只是几秒钟的喷气跳跃,气放完就没了,离能载人飞一段路的飞行汽车还远。据科技媒体 Glitchwire 报道,演示车把后排座位换成了一个装 260 公斤压缩空气的高压罐,车身四周有 10 个喷口;The Information 此前报道,因为推力和噪音太大,演示车是远程遥控的。这几点特斯拉官方没有确认。 翻跟头的是最激进的 Rocket 版:单座,只接受邀请购买,不能上公路。零到 60 英里/小时(约 97 公里/小时)加速不到 0.59 秒,极速超过 370 公里/小时。 普通人能订的是另外两个双座版本。Performance 版没有推进器,靠主动空气动力学和风扇吸地增加抓地力,加速不到 1.6 秒,订金 5 万美元。Thrust 版在车尾加了推进器,加速不到 0.9 秒,限量发售,订金 25 万美元。三个版本续航都超过 480 公里。 特斯拉没公布售价,订金不等于车价,2017 年说的起步价是 20 万美元。Performance 版的 5 万美元订金分两次付:先付 5000 美元(特斯拉说可全额退),10 天内再补 4.5 万美元,否则订单取消。 投产时间是马斯克在现场说的 2028 年,特斯拉官方帖子里没有写日期。这辆车的交付时间此前已从 2020 年先后推到 2021、2022、2025 和 2027 年。 x.com/Tesla/status/2110913438293647789/video/1
Antigravity 向付费 Google AI Pro 用户开放 Gemini 4 Argon,Argon 有单独的每周额度,不占 3.8 Flash 额度 Google 的 AI 编程工具 Antigravity 今天开始向付费的 Google AI Pro 订阅用户推出 Gemini 4 Argon。官方模型页写明只限正式付费的 Pro,试用期的 Pro 用不了,免费用户和 Google AI Plus 用户也不在范围内。能用的地方是 Antigravity 桌面 App、命令行工具 CLI 和 IDE 扩展(装在 VS Code、JetBrains 等编辑器里的插件),Antigravity IDE 里暂时选不到。目前在逐步推送,官方建议先更新到最新版。 Pro 用户用 Argon 有一份单独的额度,只按周计算,不像原有额度那样每 5 小时刷新一次;它和原来给 Gemini 3.8 Flash 用的额度分开,用 Argon 不会吃掉 3.8 Flash 的额度。每周到底给多少、哪天重置,推文和官方文档都没写。文档对所有额度的说明是,消耗多少取决于智能体实际干了多少活,任务越复杂用得越快。 官方模型说明:antigravity.google/docs/models
We’re rolling out Gemini 4 Argon in Antigravity to paid Google AI Pro subscribers today. Demand has been incredible and we've scaled capacity deliberately to get here. We’ve rolled out a separate weekly-only Argon quota for Pro on top of the existing Gemini bucket for 3.8 Flash so you have the best of Gemini for all your tasks.
查看被引用的帖子Opus 5.5 快速模式取消排队:订阅用户要额外付费,API 价格是标准版两倍 Anthropic 宣布,Claude Opus 5.5 的快速模式结束内测,取消候补名单。还是同一个模型,能力不变,回答写出来的速度最多快 2.5 倍。 费用不算在订阅里。Pro、Max 等订阅用户在 Claude Code 里用 /fast 打开快速模式后,花费不占套餐额度,直接从“额外用量”扣,也就是套餐之外单独充值、按量付费的钱。套餐额度没用完也一样从额外用量扣,没开额外用量就用不了。团队版和企业版要管理员先开启。Claude Code 这部分规则这次没变。 用 API 的开发者按 token 付费:每百万输入 token 8 美元,每百万输出 token 40 美元,正好是标准速度 Opus 5.5 的两倍。现在加一个参数就能用,不用再申请。 微软的 Microsoft Foundry 已上线,Google Cloud 即将上线。 官方文档:platform.claude.com/docs/en/build-with-claude/fast-mode Claude Code 快速模式说明:code.claude.com/docs/en/fast-mode
Opus 5.5 fast mode in the Claude Platform is no longer in research preview, and we’ve removed the waitlist! It’s the same Opus 5.5 but up to 2.5x faster, at $8 / $40 per million tokens. It's also available in Microsoft Foundry (Hosted on Azure), with Google Cloud coming soon. Fast mode in Claude Code remains unchanged, and uses extra usage credits. See our docs here: platform.claude.com/docs/en/build-with-claude/fast-mode x.com/ClaudeDevs/status/2054266327771275435?s=20
查看被引用的帖子Google 量子计算新进展:一种关键“零件”的次品率降到原来的 1/40 Google 今天在《科学》期刊发表论文,在自家量子芯片 Willow 上验证了一种制造“魔态”的新办法,做出来的魔态,坏的比例降到原来的 1/40 左右。魔态是什么、为什么重要,得先从量子计算机的一个大毛病说起。 量子计算机是一种新型计算机,理论上,在模拟药物分子、破解密码这类题目上,能比普通电脑快得多。它最小的计算单元叫量子比特,相当于普通电脑里存 0 和 1 的那个单元,但极其娇气,一点热量、一点干扰就会出错。所以到今天,还没有一台量子计算机能真正干正事。 为了不出错,科学家给量子比特设计了一套保护办法,叫“纠错”,可以理解为给数据穿上一层防护服。穿着防护服,大部分操作照样能做。麻烦的是,有一种关键操作,穿着防护服没法直接做。偏偏只靠剩下那些操作,量子计算机能算的东西,普通电脑也都能算,等于白造了。 魔态就是为这个关键操作准备的。科学家想了个绕道的办法:事先单独把一些量子比特调成一种特殊的状态,这种状态就叫“魔态”。计算中每需要做一次那个关键操作,就把一份魔态“喂”进去,效果就等于做了这个操作。喂进去就用掉了,下次还得再备一份。 所以可以把魔态想成一把一次性钥匙:量子计算机每开一次那扇关键的门,就要用掉一把。之所以叫“魔态”,是因为量子计算机比普通电脑强的那份“魔力”,就靠它来实现。 问题出在造钥匙上。魔态本身也是量子比特,一样娇气,很容易造坏,一把坏钥匙用进去,整道题就算错了。以前的办法是先造一大堆粗糙的魔态,再一遍遍提纯,非常费资源。有估算说,一台量子计算机最多可能要拿出 95% 的能力专门造魔态,真正用来算题的只剩一小部分。科学家 20 多年前就预见到这个瓶颈,一直在想办法压低成本。 2024 年,Google 的研究员提出了一个新办法,叫“培育”:在芯片上划出一小块地方,放进一份粗糙的魔态,然后一步步检查,只要哪一步发现问题,马上扔掉重来,能一路通过所有检查的,就是合格的魔态。有点像流水线上每道工序都站着质检员,次品当场就扔。 这次是第一次在真实芯片上把这个办法做成。不用培育时,大约每 1000 份魔态里有 4 份是坏的;用了培育之后,大约 1 万份里才有 1 份坏的。代价是扔掉的很多,100 次尝试里只有 8 次能留下来。 离真正能用还有多远?按《科学美国人》的报道,要用量子计算机模拟分子、帮忙设计新药,魔态坏的比例得低到百万分之一甚至一亿分之一;要破解现在网上广泛使用的 RSA 加密,得低到 100 亿份里最多坏 1 份。现在做到的是 1 万份坏 1 份。Google 自己也说,这个办法还要在更大的规模上验证,还有很多难题没解决。 原文:blog.google/innovation-and-ai/models-and-research/quantum-computing/magic-state-cultivation-quantum-computing/ 论文:science.org/doi/10.1126/science.aee7961 预印本:arxiv.org/abs/2512.13908 《科学美国人》报道:scientificamerican.com/article/googles-quantum-willow-chip-may-be-able-to-grow-magic-states/
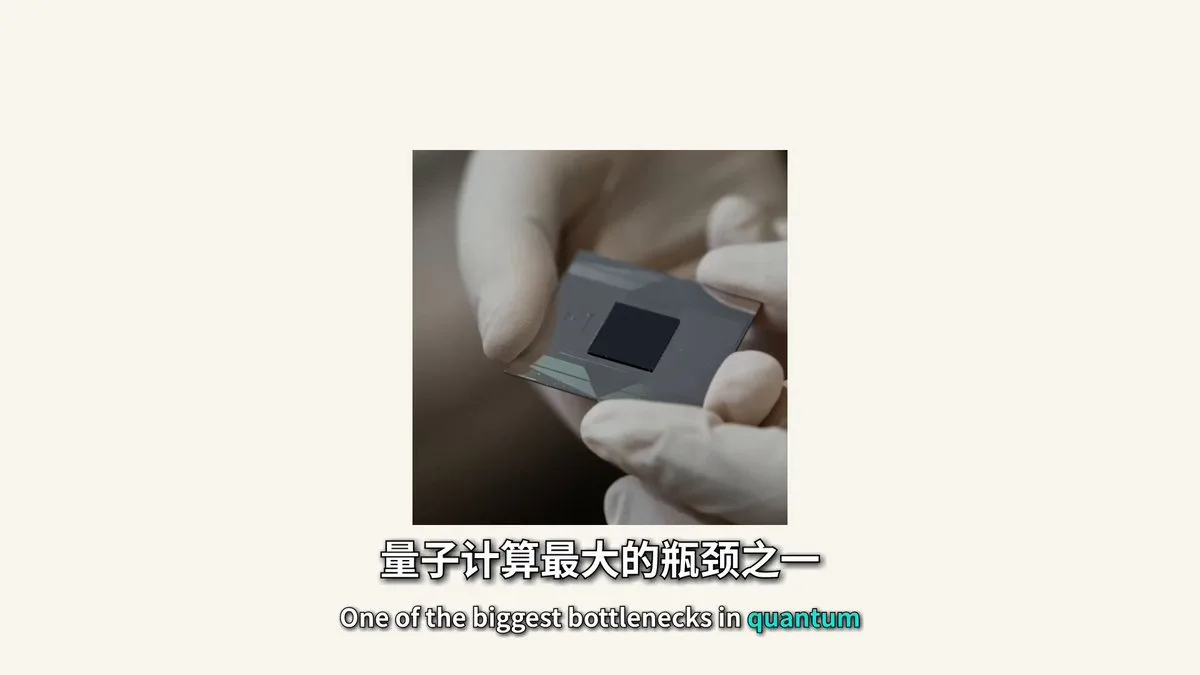
Some magical progress towards "magic state" in quantum! Our @GoogleQuantumAI team has demonstrated "magic state cultivation" on physical hardware for the first time. The result is a 40x error reduction on our Willow processor vs. previous methods, achieving a state-of-the-art 99.99% logical fidelity. It's another step towards useful, error-corrected quantum computers to help solve the hardest problems. The result is published in Science today, watch the video below to see how it works
查看被引用的帖子Cheng Lou 开源 Handwired:手写权重,把程序逻辑变成不用训练的神经网络 Midjourney 工程师、前 React 核心团队成员 Cheng Lou 开源了一个自称“玩具项目”的 Handwired:把程序里的 if-else 和循环改写成神经网络的权重。权重是手写的,不用训练,输出和对应的 JavaScript 程序完全一致,在浏览器里就能跑。 原理一行代码就能讲清。比如 result = a > 4 ? 10 : 12,在 a 是整数时可以改写成: above4 = relu(a - 4) - relu(a - 5) result = above4 × 10 + (1 - above4) × 12 relu 就是 Math.max(0, x),神经网络里最常见的激活函数。a 大于 4 时 above4 正好是 1,否则是 0。两个分支都算出来,再用它挑一个。神经网络本质上就是一堆乘法、加法加上 relu,所以程序里的判断和分支,都能收进一个大矩阵乘法里。 也许你会好奇,神经网络的输出不是带概率、不精确吗? Cheng Lou 的回答是:训练出来的才这样,按程序逻辑手写的权重,同样的输入永远得到同样的输出。 他放了三个 demo。 第一个是 Mini OS,一个有三个窗口和程序坞的小桌面,拖动、缩放、层叠、滚动、文字输入、动画都有。打开浏览器开发者工具看,页面就是普通的网页元素,没有大模型,也没有扩散模型。驱动它的是一个 130 层、9909 个权重的“神经网络”,训练次数为零,在浏览器里用 CPU 实时计算。 第二个是实时搜索 10 万份 JSON 文档,每敲一个键重搜一遍。正则匹配、JSON 解析、高亮全是这种手写网络,再转成 WebGPU 代码放到显卡上并行跑。项目文档里的实测(Apple M5 Max + Chrome):每次搜索 11 到 15 毫秒;浏览器自带的正则引擎一般 8 到 28 毫秒,遇到容易回溯的写法要 2 秒多。文档写明两者谁快说不准,所以页面把两个时间都列出来。浏览器不支持 WebGPU 时会退回 CPU,搜一遍要 13 秒。 第三个是会“学习”的相册。整个程序可微分,也就是能用训练神经网络的反向传播来调参数。你在左边画几个矩形当草图,右边的照片布局由一个小网络算出,它的 244 个参数随着你拖动实时训练。损失函数里加了一项对齐惩罚,照片会自己往一条线上靠,没有任何代码专门去对齐它们。参数很少,训练全在 JavaScript 里跑。 Cheng Lou 还设想,把一段 Handwired 程序接到 nanoGPT(Andrej Karpathy 的一个小型 GPT 训练项目)这样的模型上一起训练,模型既能写莎士比亚,又能精确执行那段程序。这个目前只是 README 里的设想,仓库里没有现成实现。 代码以 MIT 许可开源,demo 直接在网页上打开就能玩。想自己写,需要装 Bun,克隆仓库后从 template 目录的开关按钮示例开始,文档里有完整教程。 推文说“把普通 JS 代码变成神经网络”,容易让人以为能把现成代码丢进去自动转换。项目文档写的是:没有工具能把已有的 JavaScript 源码转成网络。你要用它提供的构建函数,把逻辑一句句写成比较、选择、加权求和这类操作。网络每次都要把所有操作跑一遍,不能提前退出,也不能跑运行时才知道次数的循环,所以常见的循环得改写成计数、树形合并之类的结构,文档专门用一章讲怎么改。所有数都是 32 位浮点数,每个值的取值范围要事先声明。 项目主页:chenglou.me/handwired/ GitHub:github.com/chenglou/handwired 原推文:x.com/_chenglou/status/2110557373651931267
My dear friends, I’d like to show you my latest toy project Introducing Handwired: turn your regular JavaScript code into a neural net! - no training - exact outputs vs the JS program - fully differentiable All runnable in a browser, without GPU
查看被引用的帖子Meta 发布开放权重模型 Muse Spark Open:免费下载能商用,本地跑要两台 512GB 内存的 Mac Studio Meta 10 月 15 日发布 Muse Spark Open,模型权重可以直接下载,按 Muse Model License 免费使用,商用也行。Meta 称它是“迄今最强的美国开放权重模型”。 Muse 系列推出以来,主力模型 Muse Spark 和三天前发布的 Muse Wonder 都只能通过 Meta 的产品和 API 用,开放权重的只有小模型 Muse Glimmer。这是 Meta 第一次放出大尺寸 Muse 模型的权重。 模型总共 8160 亿参数,处理每个 Token 只动用其中 420 亿,这种结构叫混合专家(MoE),算得快,但整个模型还是要全部装进内存。上下文 100 万 Token,能读文字、图片、视频和音频,输出文字,主打写代码和让 AI 长时间自己干活。 【能不能下载,能不能商用】 能下载。Hugging Face、亚马逊 SageMaker、Google Cloud Model Garden 和微软 Foundry 都提供权重。Hugging Face 上要先登录填申请表,写真实姓名、出生日期和完整机构名称,提交后不能改。 能商用。许可证允许使用、修改、微调、蒸馏(用它的输出训练别的模型)、再分发和出售,不收费。条件有三条。 第一,用了它的产品要在界面、文档、网站或设置菜单里显著标出“Built with Muse Spark Open”。 第二,遵守附带的使用政策:不能用于军事、武器、关键基础设施等高风险用途,不能在没有执业资格时提供金融、法律、医疗专业服务,也不面向 18 岁以下用户。 第三,卖模型接口的大公司要单独签协议。具体是:你把它或基于它改的模型通过 API 之类的方式卖给别人调用,而你的公司连同关联公司过去 12 个月总营收超过 2000 万美元,就要先通知 Meta、另签协议。算的是公司总营收,不只是这项业务的收入。 把它嵌进自己的 App 做功能、公司内部用、做研究,都不受第三条限制,公司多大都一样。Llama 当年的许可证门槛是月活 7 亿用户,这次换成了针对模型接口生意的营收门槛。 【普通电脑能不能跑】 跑不了。模型卡写的要求是:压缩到英伟达 4 位精度格式 NVFP4 的版本至少要 700GB 显存,原始 BF16 版本要 2TB。 Meta 说它针对两台 M5 Ultra Mac Studio 做了优化:每台最多 512GB 统一内存,两台连起来凑出 1TB,用苹果的 MLX 框架运行。官方没写在 Mac 上跑的是哪个压缩版本,也没给速度。 有服务器的开发者,SGLang、vLLM、TensorRT-LLM、llama.cpp 等主流推理框架都能跑,也可以用 PyTorch 和 TorchTitan 微调。 没有这种硬件,就调 API:Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI 提供接口,价格由各平台定,Meta 没公布。 【和其他模型比怎么样】 Meta 只拿它和开放权重模型比:美国的 Inkling(前 OpenAI CTO Mira Murati 创办的 Thinking Machines 出品)和英伟达 Nemotron 3 Ultra,法国的 Mistral Large 4,中国的通义千问 Qwen3.8、智谱 GLM 5.3、月之暗面 Kimi K3。以下成绩都来自 Meta 的模型卡。 第三方机构 Artificial Analysis 的综合智能指数,Muse Spark Open 39 分,Inkling 26,Nemotron 3 Ultra 23,“美国最强”说的是这一层。放到全部开放权重模型里,它低于 GLM 5.3 的 45 和 Kimi K3 的 44,和 Qwen3.8 的 40 接近。Artificial Analysis 开源榜目前排第一的是小米 MiMo-V2.6-Pro,46 分,Meta 的对比表里没有它。 单项领先的是调用工具和难题推理:测模型通过 MCP 协议调外部工具完成任务的 MCP-Atlas,89.2 分,对手最高 84.5;不借助工具做“人类最后的考试”(HLE,一套极难的跨学科考题),26.1 分,对手最高 22.2。 写代码偏弱:命令行任务 Terminal-Bench 76.4 分,Kimi K3 85.0、GLM 5.3 83.9;软件工程任务 DeepSWE 60 分,Kimi K3 68、GLM 5.3 67。 最突出的是防越狱。StrongREJECT 测的是模型被人诱导时会不会输出有害内容,分数越低越安全,它是 0.5 分,其他模型都在 60 分以上。Meta 说开放权重版额外做了安全训练。 和自家闭源模型比,Meta 三天前引用的 Artificial Analysis 数据里,Muse Wonder 52 分,Muse Wonder Full 56 分,Muse Spark Open 低一截。 原文:x.com/AIatMeta/status/2110779754274292212 官方博客:research.meta.ai/blog/muse-spark-open 模型卡:huggingface.co/meta-models/Muse-Spark-Open-816B-A42B
Today we’re releasing Muse Spark Open, the most capable US open-weight model to date. Built for coding and agentic work, it excels at long-horizon tasks, complex software engineering, and multi-step reasoning. Key Model Specs: → 816B total / 42B active parameters → 1M token context window → Natively multimodal across text, image, video, audio
查看被引用的帖子