通过我们的最新更新,现在在 Optima 中创建和运行自定义基准测试比以往任何时候都更容易。这让你能够用针对自身用例量身定制的评估来评测模型 使用 Optima,你可以: ➤ 只需 3 步,就能从想法变成个性化基准测试 ➤ 针对你的用例比较模型的智能程度、成本和速度 ➤ 在最新模型上运行你自己的任务
机器翻译


博主雷达 / @artificialanlys
@artificialanlys
粉丝 16.1万关注 685最近同步 10/19 20:54雷达库已收录
评测机构官方号 · Artificial Analysis
去 X 主页数据积累中
通过我们的最新更新,现在在 Optima 中创建和运行自定义基准测试比以往任何时候都更容易。这让你能够用针对自身用例量身定制的评估来评测模型 使用 Optima,你可以: ➤ 只需 3 步,就能从想法变成个性化基准测试 ➤ 针对你的用例比较模型的智能程度、成本和速度 ➤ 在最新模型上运行你自己的任务
Reflection 的首个模型 Beam 在 Artificial Analysis 智能指数上得分 30,在美国开放权重模型中排名第 2 Beam 是一个开放权重模型,总参数 501B,激活参数 23B,已在 @huggingface 上发布 恭喜 @reflection_ai 发布! 要点: ➤ 美国开放权重模型第二:Beam 得分 30,仅次于 Meta 的 Muse Spark Open(39),领先于昨天发布的 NVIDIA Nemotron 3.5 Super VL(26)。在中国以外,只有 Muse Spark Open 和阿联酋的 K2 Horizon(31)得分更高 ➤ 智能水平下的 token 效率:Beam 在每个智能指数任务上使用约 26k 输出 token,而比它高一分、领先一位的 K2 Horizon 用了两倍(约 52k)。专有模型仍处于前沿,GPT-6 Astra(max)在相同预算(约 27k)下得分 53 ➤ 在智能体工作流上表现强,在终端上较弱:Beam 在 AutomationBench-AA 上得分 48.5%,比 K2 Horizon(37.2%)高 11 个百分点,与 Qwen3.8 27B(48.2%)持平。Terminal-Bench 4.0 是弱项,Beam 得分 3.0%,落后于 Qwen3.8 27B(5.6%)和 Muse Spark Open(8.1%) ➤ 知道得更多,也猜得更多:在 AA-Omniscience 上,它正确回答了 33% 的问题,远超 K2 Horizon(18%)和 Qwen3.8 27B(16%)。但它的幻觉率为 47%,而 K2 Horizon 为 26%、Qwen3.8 27B 为 30%,这让 Beam 的净指数得分为 1.5,领先于这两个对手(−3.0 和 −10.0) 其他模型细节 上下文窗口:1M tokens 模态:文本 参数:501B / 23B
Beam 在 Artificial Analysis Cyber Index 上得分 34%,成为我们测试过的美国开源权重模型中领先的一个 得益于其 token 效率,它也位于 Cyber Index 与每任务输出 token 数前沿曲线上,与 GPT-6 Sol(Daybreak Blue)并列
d1-ultra 在 AA-Omniscience-Decision 上取得了最高的非幻觉率,达到 85%,是第二名 Microsoft-Decision-1 的 40% 的两倍多。相比 d1 更多地选择弃答,导致准确率降至 32%,而 d1 为 41%。
Liquid AI 发布了 d1-ultra,在 Artificial Analysis Decision Index v1.0 上拿下第一,背后是幻觉率的下降 d1-ultra 是 @liquidai 推出的新决策模型,接续他们本月初发布的 d1。定价为每 100 万输入 token 0.042 美元,而 d1 是每 100 万输入 token 0.02 美元。和 d1 一样,d1-ultra 也只按输入 token 计费。 要点: ➤ d1-ultra 以 65 分领跑 Artificial Analysis Decision Index v1.0:d1-ultra 得分 65,领先于最近发布的 Jev 1.14(57 分)以及 GLiDE 和 Microsoft-Decision-1(54 分) ➤ d1-ultra 的 65 分得益于在 AA-Omniscience-Decision 上低得多的幻觉率:d1-ultra 在 AA-Omniscience-Decision 上的非幻觉率为 85%,相比 d1 的 2% 大幅提升。非幻觉率指的是在未正确回答的问题中,模型选择“我不知道”的比例,衡量的是一个决策模型在判断自己知识边界、知道何时不该作答方面的能力。在 d1-ultra 幻觉率下降的同时,它的准确率(答对问题的百分比)也下降了。它的准确率为 32%,相比 d1(41%)下降了 9 个百分点 ➤ d1-ultra 的单任务耗时在所有决策模型中第三低:d1-ultra 的单任务耗时为 92 毫秒,在已测量的决策模型中第三低,仅次于 Jev 1.14 的每任务 78 毫秒和 Celeris-1 Decision 的每任务 63 毫秒 ➤ d1-ultra 的定价与其他决策模型相当,为每 100 万任务 32 美元:以每 100 万任务 32 美元的价格,d1-ultra 与 Celeris-1 Decision(每 100 万任务 32 美元)和 Microsoft-Decision-1(每 100 万任务 31 美元)定价相当,是 d1 和 Mercury Decide(每 100 万任务 15 美元)价格的两倍多,但不到 GPT-6 Luna (Decisions)(每 100 万任务 79 美元)价格的一半
在 DeepSeek V4.1 Flash 上,Vera Rubin 每兆瓦吞吐量约为 GB300 的 3.4 到 3.6 倍,单用户速度在约 230 到约 350 tok/s 之间,而单台 4-GPU 服务器就能达到单用户 906 tok/s,是我们排行榜上所有模型里最快的结果
NVIDIA Vera Rubin NVL72 的初步结果现已上线 AA-AgentPerf,在 DeepSeek V4 Pro 上,其每兆瓦总吞吐量最高可达前代 GB300 NVL72 的约 5.7 倍,DeepSeek V4.1 Flash 上约 5.4 倍,GLM-5.2 上约 3.0 倍,Kimi K3 上约 2.8 倍 Vera Rubin 是 NVIDIA 的 Blackwell 继任者,Vera Rubin NVL72 是其机架级系统,配备 72 块 Rubin GPU 和 36 颗 Vera CPU。每块 Rubin GPU 拥有与 Blackwell Ultra 相同的 288 GB 内存,但内存带宽提升 2.4 倍,NVLink 带宽提升 1.7 倍,密集 NVFP4 算力提升 2.3 倍。NVIDIA 提交了所有 Vera Rubin 结果,运行 TensorRT-LLM 和 vLLM,搭配 NVIDIA Dynamo AA-AgentPerf 是我们的智能体推理性能基准测试。它回放真实的智能体编程会话,包括长缓存上下文和工具调用延迟,以真实衡量日常智能体工作负载中的推理性能。我们测量每兆瓦实测 GPU 功耗下的系统总吞吐量,以及不同并发水平下的单智能体输出速度(请求的 p25),以展示系统利用率与单个用户体验之间的权衡 初步结果: ➤ Vera Rubin 的领先优势在更快的单用户速度下最大,此时 GB300 的吞吐量会大幅下降。在 DeepSeek V4 Pro 上,从每用户约 120 tok/s 提升到约 165 tok/s,GB300 的每兆瓦吞吐量损失 81%,而 Vera Rubin 仅损失 16% ➤ 在峰值吞吐量下,两者更为接近,Vera Rubin 在 DeepSeek V4 Pro 上达到每兆瓦 272M tokens/s,而 GB300 为 239M(1.14 倍);DeepSeek V4.1 Flash 上为 571M 对 395M(1.45 倍);GLM-5.2 上为 272M 对 201M(1.35 倍);Kimi K3 上为 70M 对 56M(1.26 倍)。我们预计,随着 Vera Rubin 内核及其他服务软件得到优化,两套系统之间的差距将进一步扩大 ➤ Vera Rubin 在我们的排行榜上创下了 DeepSeek V4.1 Flash(906 tok/s,所有模型中最快的结果)、GLM-5.2(408 tok/s)和 Kimi K3(255 tok/s)的最快单用户速度 恭喜 @nvidia 取得如此强劲的成绩! 阅读完整分析:artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf
Muse Spark Open(xhigh)在 AA-Omniscience(25)上领先所有开放权重模型,这得益于它是所有得分 30 及以上的开放权重模型中幻觉率最低的(24%)
Meta 发布了 Muse Spark Open,一个 816B(42B 激活)的开源权重模型,在 Artificial Analysis 智能指数上得分 39,成为美国排名第一的开源权重模型 Muse Spark Open(xhigh)比 Muse Glimmer(high,17)高出 22 分,后者是 Meta 八月发布的 30B 稠密开源权重模型。它也领先于 NVIDIA 的 Nemotron 3.5 Super VL(26),这是得分第二高的美国开源权重模型,于今天发布 @AIatMeta 在公开发布前与我们分享了访问权限用于基准测试。祝贺 @AIatMeta、@finkd 和 @alexandr_wang 发布! 关键要点: ➤ 开源权重达到 Meta 八月旗舰的水平。Muse Spark Open 与 Muse Spark 1.2(xhigh,40)仅差一分。它在 AutomationBench-AA 上更强,幻觉率更低,但在 GDPval-AA v2.1、CritPt 和 AA-Omniscience 准确率上较弱。在 Meta 当前的产品线中,它落后 Muse Wonder(max,52)13 分,落后 Muse Wonder Full(max,56)17 分 ➤ Token 高效,每任务成本适中。Muse Spark Open 在智能指数任务上使用 40k 输出 token,是九个得分最高的开源权重模型中最少的:例如比 Muse Spark 1.2(xhigh,48k)少 16%,比 GLM-5.3(max,71k)少 43%,后者是规模上最接近的中国同类模型。Together AI、Fireworks 和 Baseten 在发布时提供该模型,价格为每 1M 输入/输出 token $1.25/$4.25(缓存输入 $0.15)。按此定价,每个智能指数任务花费 $0.84。这比 Muse Spark 1.2($0.97)在相同每 token 价格下更便宜,不到 GLM-5.3(max,$2.01)的一半,但约为 DeepSeek V4.1 Flash(max,$0.27)的三倍 ➤ 相比中国开源权重领先者,在智能体工作上相对较弱。在九个得分最高的开源权重模型中,Muse Spark Open 在指数中的四项智能体评估中排名最后,但在其余六项综合中排名第四,并且在 AA-Omniscience(25)上领先所有开源权重模型。GLM-5.3(max),规模上最接近的中国模型,其 6 分的领先全部来自智能体评估 ➤ 可在单节点或两台 Mac Studio 上自托管。BF16 权重约 1.6TB。Meta 的 NVFP4 checkpoint 仅量化 256 个专家,将权重削减至约 530GB。Meta 表示这可在四块 Blackwell Ultra GPU 或八块 H200 上运行,或使用 MLX 在两台 512GB M5 Ultra Mac Studio 上运行。架构使用 62 层,带分组查询注意力(16 个 KV 头),每个 token 激活 256 个专家中的 8 个,以及一个 1.8B 参数的 Perception Encoder 用于视觉 其他模型细节: ➤ 参数:总计 816B,激活 42B(MoE) ➤ 上下文窗口:1M token ➤ 许可证:Muse Model License,一种自定义许可证,要求“Built with Muse Spark Open”署名,并且对于年收入超过 $20M 的 Model-as-a-Service 业务需要与 Meta 单独协议 ➤ 输入模态:文本、图像、视频和音频。输出:文本 ➤ 可用性:权重在 Hugging Face 上(BF16 和 NVFP4),API 访问通过 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter 和 Together AI
NVIDIA 的 RTX Spark N1X 把最高 128 GB 统一内存和一块 Blackwell GPU 塞进了一台 Windows 笔记本。在我们的首批 AA-AgentPerf-Local 结果中,一台 RTX Spark 笔记本用 Qwen3.8 27B 跑完我们的本地 agent 工作负载只用了 18.7 分钟 RTX Spark 的 N1X 芯片本质上就是 DGX Spark 上的那颗 GB10(20 核 Arm CPU、6,144 核 Blackwell GPU),最高 128 GB 内存、带宽 300 GB/s。我们测试了一台原型机 15 英寸 Surface Laptop Ultra(128 GB,5,900 美元),插着电源、Windows 设为高性能模式,在有的情况下使用 NVIDIA 公布的 llama.cpp 配方 关键结果: ➤ 在 Qwen3.8 27B 上,RTX Spark 笔记本跑完我们的默认工作负载(8 个记录的 agent 任务、168 个模型回合)用时 18.7 分钟,接近 DGX Spark(17.3),比 MacBook Pro(M5 Pro,64 GB,37.6)快 2.0 倍,比 AMD Ryzen AI Halo(34.5)快 1.8 倍。GeForce RTX 5090 台式机最快,4.9 分钟 ➤ 在 Qwen3.6 35B A3B 上用时 7.6 分钟,接近 DGX Spark(7.3),比 MacBook Pro(11.9)快 1.6 倍 ➤ 在 Ling 3.0 Flash 上——我们测试的当前最大模型——用时 15.3 分钟,接近 DGX Spark(14.9),比 Ryzen AI Halo(25.1)快 1.6 倍。它 77 GB 的权重在 MacBook Pro 或 RTX 5090 上都放不下 阅读完整分析:artificialanalysis.ai/articles/nvidia-rtx-spark-agentperf-local
这些系统的价格只是大致参考,每周都会变动。按当前价格,5,900 美元的 RTX Spark 笔记本比 MacBook Pro(约 3,700 美元)和 Ryzen AI Halo(4,000 美元)都贵,但比 DGX Spark(约 6,000 美元)略便宜,而 GeForce RTX 5090 台式机(约 9,500 美元,其中显卡约 7,000 美元)是最贵的 在这个价位上,系统越贵,在我们测试的每个模型上完成工作负载的速度就越快。随着我们加入更多系统和运行时,我们预计这种情况会发生变化。我们的排行榜支持你输入自己的价格
Nemotron 3.5 Super VL 是美国得分最高的开放权重模型,在 Intelligence Index 上拿到 26 分。它略胜 Thinking Machines 的 Inkling Small(26 分),并超过了 NVIDIA 之前的旗舰 Nemotron 3 Ultra(23 分)和 Meta 的 Muse Glimmer(17 分) 尽管有所进步,美国在开放权重智能上仍落后于阿联酋(K2 Horizon 375B A23B,31 分)和中国(MiMo-V2.6-Pro,46 分)。
Nvidia 的 Nemotron 3.5 Super VL 现在是领先的美国开放权重模型,在 Artificial Analysis 智能指数上得分 26 Nemotron 3.5 Super VL 的智能水平达到其前代 Nemotron 3 Super(13)的两倍,而且每个任务使用的输出 token 少了约 60% 它和 Nemotron 3.5 Bolt 74B-A9B 24GB 一同发布,后者是其全新 Bolt 系列的首个模型,在智能指数上得分 21 恭喜 @NVIDIAAI 发布这些新模型! 要点: ➤ 领先的美国开放权重模型:Nemotron 3.5 Super VL 得分 26.5,略胜 Thinking Machines 的 Inkling Small(25.7),领先于 NVIDIA 的 Nemotron 3 Ultra(23)和 Meta 的 Muse Glimmer(17) ➤ Bolt 距离 Ultra 只差 2 分:Nemotron 3.5 Bolt 74B-A9B 24GB 得分 21,落后 Nemotron 3 Ultra 550B A55B(23)1.5 分。这个 2 bit 内存的模型参数量约为 Ultra 的七分之一(74B 对 550B),激活参数量为六分之一(9B 对 55B) ➤ Super 3.5 VL 在 NVFP4 下近乎无损:Nemotron 3.5 Super VL 以 NVFP4 发布,在智能指数上与 BF16 权重的得分差距在 0.1 分以内,没有任何单项指标变动超过 2.6 分 Nemotron 3.5 Super VL 详情 上下文窗口:1M tokens 模态:视觉和文本输入;文本输出 参数:120B / 12B Nemotron 3.5 Bolt 74B-A9B 24GB 详情 上下文窗口:256k tokens 模态:视觉和文本输入;文本输出 参数:74B / 9B
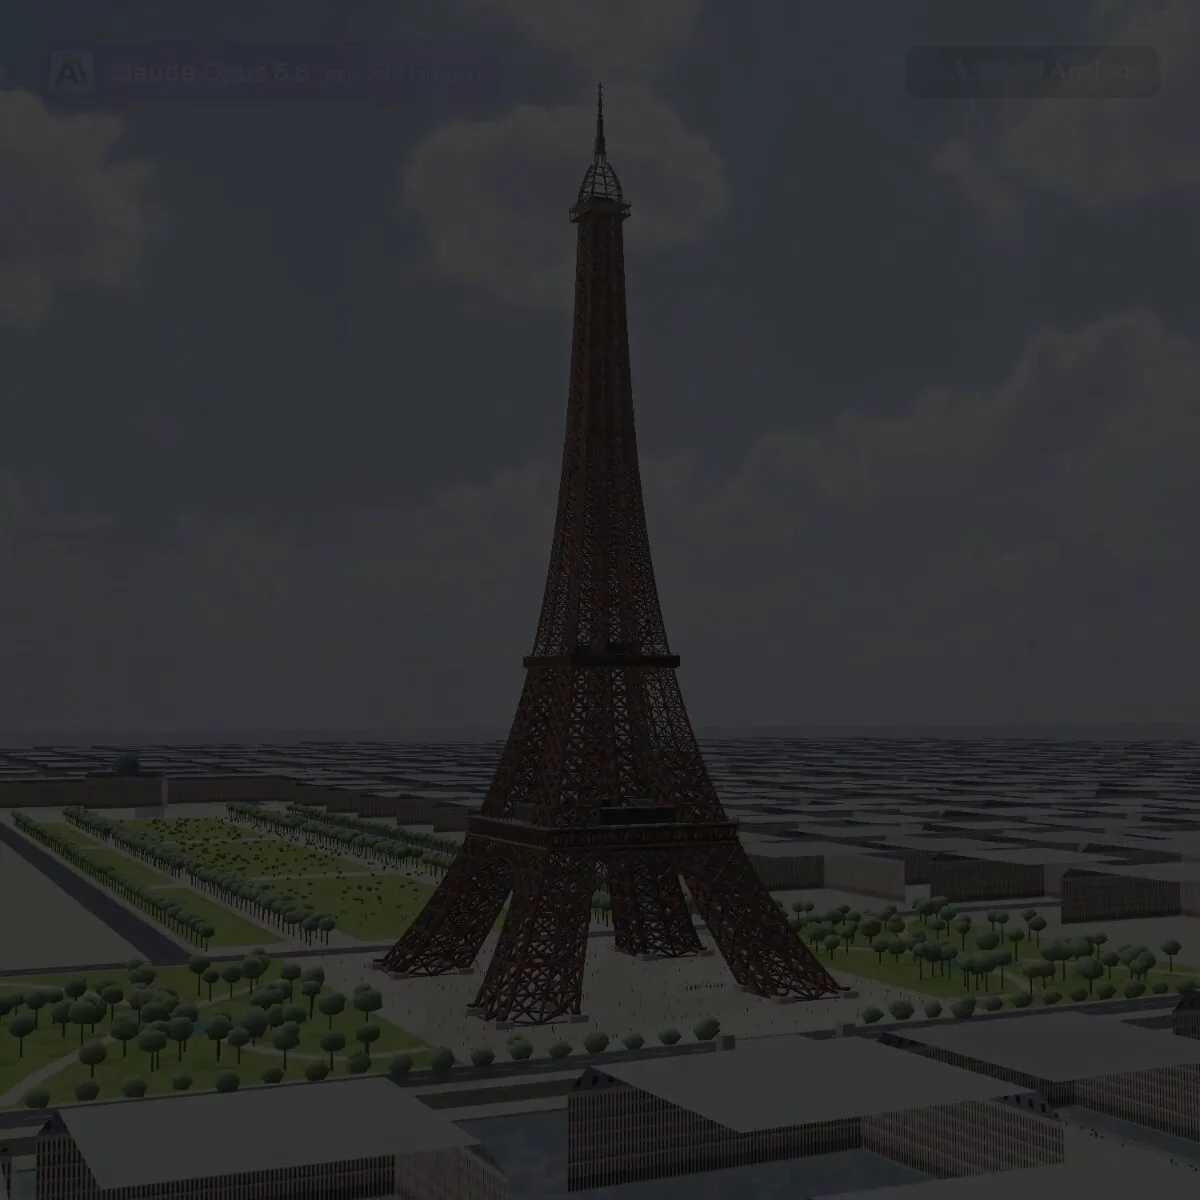
我们让 AI 模型离线用 3D 搭建埃菲尔铁塔。其中两个模型凭记忆,把全部 72 位科学家的名字按顺序加了上去 我们完全没想到会这样。每个 AA-3D 模型拿到的都是同一份约 200 字的简要说明,内容涉及铁塔的形状、格构、平台和灯光。里面从未提到这些名字。 古斯塔夫·埃菲尔把 72 位法国科学家、工程师和数学家的名字刻在铁塔第一层平台下方,每面 18 个。Claude Opus 5.5 和 Grok 4.7 写出了全部 72 个名字,每一面都按真实顺序排列。 Claude Opus 5.5 还把每一组名字放在了在巴黎朝向相同的那一面。 每个模型都是作为智能体在无法联网的沙盒中搭建自己的场景。两次运行中,这些名字都最先出现在模型自己写的代码里,而不是它读取的某个文件或工具输出中。 恭喜 @spacexai、@elonmusk 和 @AnthropicAI,收获了两个知识相当扎实的模型
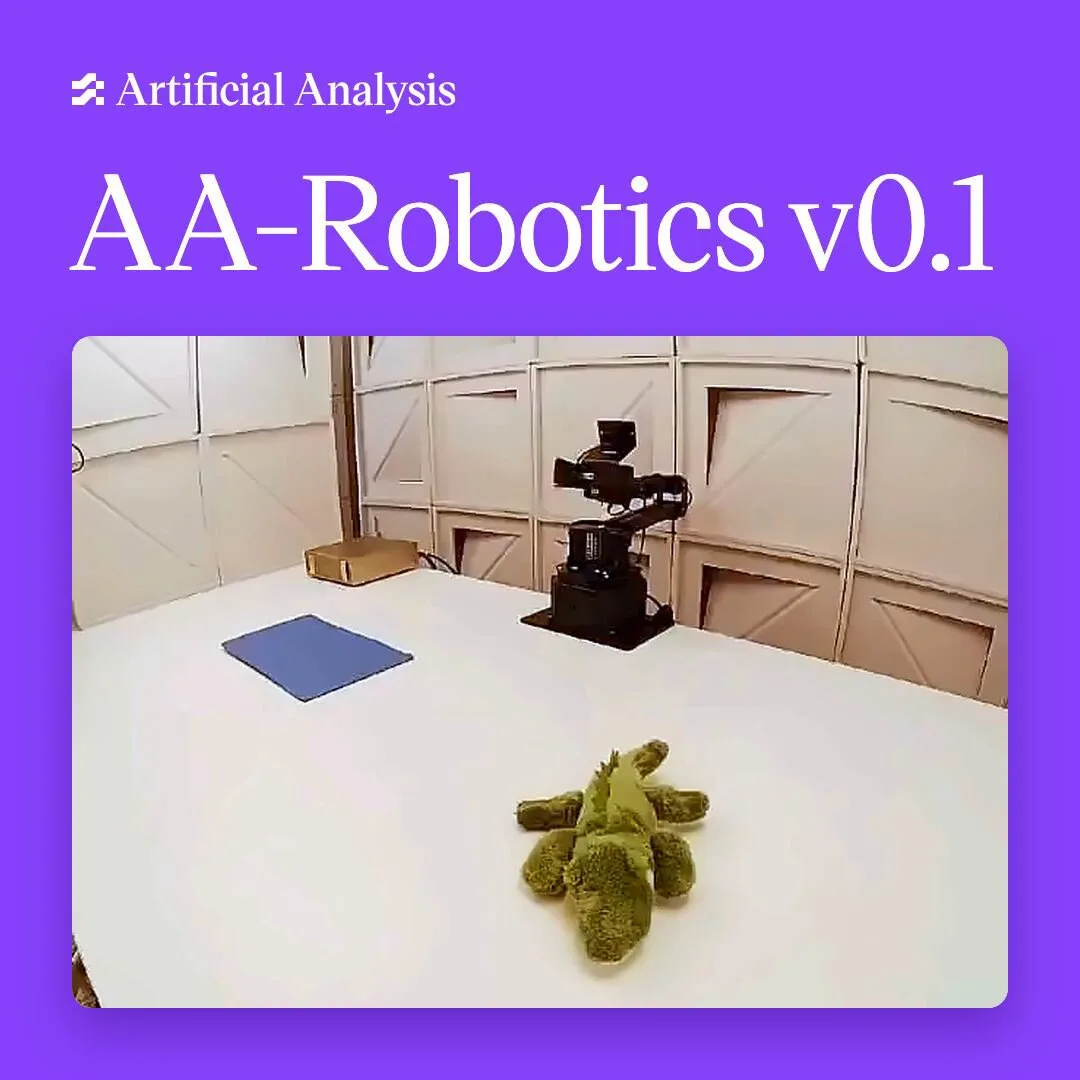
欢迎来到具身智能的时代。 我们正式推出 AA-Robotics v0.1,这是我们的一项研究预览,用来衡量前沿语言模型在物理世界中的理解、规划和行动能力。在 v0.1 中,每个模型都会获得一台 6 轴机械臂(5 个关节加一个夹爪)的控制权,以及一个简单的目标。我们今天公布前八个任务的结果。 我们发现,运行在编程智能体框架中的前沿语言模型,最近已经能够直接操控机械臂完成简单任务。但如今,它们对于任何形式的生产使用来说都太慢、太贵了——几乎比人类基线差了两个数量级。我们预计这种情况会很快改变。 GPT-6 Astra 在 AA-Robotics v0.1 中排名第一,紧随其后的是 GPT-6.1 Sol、Gemini 4 Argon 和 Claude Opus 5.5。 AA-Robotics v0.1 详情: ➤ 我们的前八个任务测试了一系列能力:控制与灵巧度(精准抓取和物体操作)、空间推理(物体之间如何相互作用)以及适应性(模型如何应对意外情况) ➤ 模型只会收到简短指令:如何连接到机械臂(通过一个简单的 HTTP API)、机械臂的名称,以及如何提交一次尝试。它们可以通过四个摄像头查看场景,并编写和运行代码来规划并发送动作 ➤ 一旦模型提交一次尝试,其最终状态会根据任务的通过标准进行评分。通过得 100 分;未完成的尝试获得部分分数。所有尝试均为零样本 关键发现: ➤ GPT 家族登顶排行榜:GPT-6 Astra 得分 69,领先于 GPT-6.1 Sol 的 65 和 Gemini 4 Argon 的 55。Claude Opus 5.5(49)和 Claude Fable 5.1(46)落后 ➤ 如今的模型在我们的任务上慢得惊人,完成每个桌面任务平均需要约 30 分钟 ➤ 成本差异巨大:GPT-6.1 Sol 最便宜,平均每个任务 $1.93;GPT-6 Astra 最贵,成本 $16.36,是前者的八倍多 ➤ 与人类相比,如今表现最好的前沿语言模型大约慢 100 倍,贵 10 倍 更多结果、片段,以及 AA-Robotics v0.1 的工作原理,见下方推文串。
AA-Robotics v0.1 是怎么运作的 ➤ 模型运行在一个隔离容器里,只拿到简短说明:怎么连上机械臂、这是哪款机械臂(一台 Hiwonder NexArm,没有更多规格),以及如何把一次尝试提交为完成。 ➤ 它们可以通过四个摄像头查看场景,三个装在桌子周围,一个装在机械臂手腕上,并且可以在容器里编写和运行代码来规划并发送动作。 ➤ 一旦模型提交任务等待评审,最终状态就会按该任务的通过标准来评分。通过得 100 分,任务未完成但部分成功也会给分。所有任务尝试都是零样本。
在我们的 Speech Agent Arena 里,人们进行盲测实时语音对话并选出自己更喜欢的模型,Grok Voice 3.0 首次登场就排在第 3,Elo 为 1070,落后于 Gemini 3.1 Flash Live Minimal(1100)和 Gemini 3.8 Live(1088),领先于 GPT-Live-1(Sol, low)的 1057。它还成功完成了 94.8% 的任务,任务成功率排名第 1,领先于 Gemini 3.8 Live 的 93.2%。Grok Voice 2.0 的 Elo 为 1011,任务成功率为 94.6%。
SpaceXAI 的 Grok Voice 3.0 是新的领先语音到语音模型,在 Artificial Analysis 语音到语音指数上以 86.9 首次登顶,同时在延迟方面也很有竞争力 Grok Voice 3.0 是 @SpaceXSI 的 Grok Voice 2.0 的继任者,这是一款通过 SpaceXAI Realtime API 提供的语音到语音模型,价格为每分钟 $0.08。我们通过 SpaceXAI Realtime API 使用 Rex 语音对 Grok Voice 3.0 进行了评估。 主要结论: ➤ 语音到语音指数:Grok Voice 3.0 以 86.9 首次登顶,领先于 GPT-Live-1(Astra,medium)的 83.2、Gemini 3.8 Live Extended Thinking(High)的 82.6 和 GPT-Live-1(Sol,low)的 80.1。它相比 Grok Voice 2.0 的 81.3 有所提升(+5.6 分),相比不到六个月前发布的 Grok Voice 1.0 的 73.7 也有所提升(+13.2 分)。该指数取语音推理(Big Bench Audio)、智能体表现(Tau Voice)、竞技场偏好和任务成功率的平均值 ➤ 语音智能体竞技场:Grok Voice 3.0 在偏好度上以 Elo 1070 排名第 3,落后于 Gemini 3.1 Flash Live Minimal(1100)和 Gemini 3.8 Live(1088),领先于 GPT-Live-1(Sol,low)的 1057,并在任务成功率上以 94.8% 排名第 1,为榜单最高,略高于 Grok Voice 2.0 的 94.6%。Grok Voice 2.0 以 Elo 1011 落后 ➤ Tau Voice:Grok Voice 3.0 在我们的 Tau Voice 基准实现上以 71.6% 拿下第 2 名,落后于 GPT-Live-1(Astra,medium)的 74.5%,领先于 Gemini 3.8 Live Extended Thinking(High)的 68.6% 和 GPT-Live-1(Sol,low)的 59.3%——相比 Grok Voice 2.0 的 56.5% 有所提升 ➤ Big Bench Audio:Grok Voice 3.0 在音频推理上得分 98.5%,领先于 Gemini 3.8 Live Extended Thinking(High)的 97.7% 和 Grok Voice 2.0 的 97.2% ➤ 速度:Grok Voice 3.0 在 Big Bench Audio 上的平均首次音频时间为 0.81 秒,明显领先于 GPT-Live-1(Sol,low)的 1.24 秒、GPT-Live-1(Astra,medium)的 1.34 秒和 Gemini 3.8 Live Extended Thinking(High)的 1.35 秒,但慢于 Grok Voice 2.0 的 0.70 秒 ➤ 成本:Grok Voice 3.0 每小时输入音频成本为 $4.80,与 Grok Voice 2.0 相同。这高于 GPT-Live-1(Sol,low)的 $4.47 和 Gemini 3.8 Live Extended Thinking(High)的 $3.50,低于 GPT-Live-1(Astra,medium)的 $5.83,并且比 GPT-Realtime-2.1 High 的 $10.75 便宜约 2.2 倍 祝贺 @elonmusk 和 @SpaceXSI 团队 🚀 更多细节见下方 ⬇️
MI355X 在 DeepSeek V4 Pro 0813 上表现最强。在每用户 35 到 75 tok/s 之间,它每 MW 的吞吐量比 B200 高约 15% 到 40%,在每用户 33 tok/s 时达到约 94M tokens/s per MW 的峰值,而 B200 只有在 13 tok/s 时才能达到这一水平。超过每用户约 80 tok/s 后 B200 反超,而对于单个 agent,差距变为 MI355X 240 tok/s 对 B200 367 tok/s。其他 NVIDIA 硬件的分离式多节点配置大多高于两者,例如 B300 使用两个 8-GPU 节点时,在每用户 116 tok/s 下达到 125M tokens/s per MW。